Data lakehouse: qué es, para qué sirve y ejemplo práctico
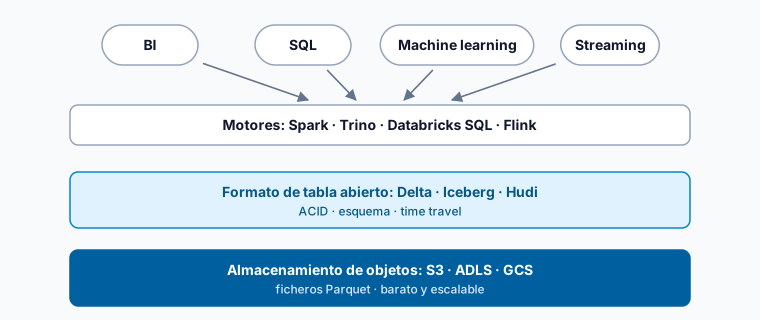
Data lakehouse
¿Qué es?
Un data lakehouse es una arquitectura de datos que combina las capacidades de un data lake (almacenamiento masivo de datos en formatos abiertos como Parquet sobre almacenamiento barato tipo S3) con las capacidades transaccionales y de gestión de un data warehouse (ACID, gobierno, esquemas, rendimiento en consultas analíticas).
¿Para qué sirve?
Para evitar el típico problema de tener dos plataformas separadas: un lago donde aterrizan datos crudos y un warehouse donde se modelan para análisis. El lakehouse pretende cubrir ambos roles con la misma capa de almacenamiento, reduciendo coste de infraestructura y eliminando sincronizaciones entre sistemas.
Ejemplo
Una empresa de retail usa Databricks (lakehouse sobre Delta Lake) para almacenar:
- Logs de clickstream como datos crudos en formato Parquet sobre S3.
- Tablas modeladas de ventas con dimensiones y hechos, sobre el mismo storage gestionado con Delta + Unity Catalog.
Sus analistas consultan ambas con SQL desde la misma plataforma, sin pipelines de copia entre lake y warehouse.
Tecnologías de referencia
- Delta Lake (estándar abierto creado por Databricks).
- Apache Iceberg (adoptado por Snowflake, Dremio, AWS Athena, Trino).
- Apache Hudi (creado por Uber, soportado por Onehouse).
Los tres comparten el mecanismo que hace posible el resto: en vez de sobrescribir ficheros, añaden versiones y registran en un log de metadatos qué ficheros forman la tabla en cada momento. De ahí salen las garantías ACID sobre almacenamiento de objetos y también la posibilidad de consultar la tabla tal como estaba antes, lo que se conoce como time travel.
El mantenimiento que nadie cuenta en la demo
Ese mismo mecanismo —añadir ficheros en vez de sobrescribirlos— tiene una contrapartida: una tabla con ingesta frecuente acumula miles de ficheros pequeños, y a partir de cierto punto el motor tarda más en gestionarlos que en leer los datos. Es la causa habitual de que un lakehouse funcione bien el primer mes y vaya lento al sexto sin que nadie haya cambiado nada.
Los tres formatos lo resuelven con la misma operación de mantenimiento, la compactación de ficheros, que conviene programar desde el principio y no cuando las consultas ya molestan.
Más información
- Almacenamiento de datos: data lakes, data warehouses y lakehouses — capítulo de la guía práctica de arquitectura de datos de Dataprix.
- Compara plataformas de datos en el directorio de software de Dataprix.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.