Apache Iceberg: qué es, para qué sirve y ejemplo práctico
Apache Iceberg
¿Qué es?
Apache Iceberg es un formato abierto de tabla (open table format) para data lakes. No es una base de datos ni un motor de consulta: es una especificación de cómo organizar ficheros de datos (típicamente Parquet) sobre almacenamiento de objetos (S3, ADLS, GCS) para que se comporten como una tabla con garantías ACID, esquema gobernado y rendimiento analítico.
Diseñado originalmente en Netflix y donado a la Apache Software Foundation, hoy es el estándar de tabla abierta más ampliamente adoptado por los grandes proveedores cloud y lakehouses.
Para qué sirve
Resuelve los problemas históricos de los data lakes “planos”:
- Transacciones ACID: lecturas y escrituras concurrentes sin perder consistencia.
- Evolución de esquema: añadir, renombrar o reordenar columnas sin reescribir los datos.
- Time travel: consultar el estado de la tabla tal como estaba hace una hora, una semana o un commit concreto.
- Particionado oculto: las consultas no tienen que conocer el esquema de particiones físico — Iceberg lo gestiona.
- Compactación y mantenimiento: operaciones de optimización (compactación de small files, expiración de snapshots) integradas en la especificación.
Cómo funciona
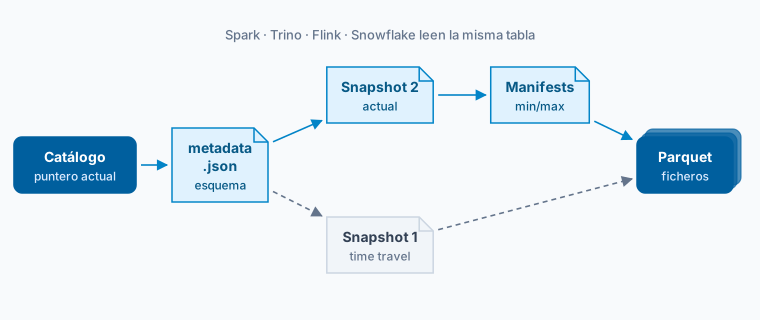
Iceberg organiza la tabla en tres niveles de metadatos sobre los ficheros de datos:
- Data files: los Parquet (o ORC, Avro) reales con las filas.
- Manifest files: listas de data files con estadísticas por columna.
- Manifest lists: agrupan los manifests de un snapshot.
- Metadata file: apunta al manifest list actual y guarda el historial de snapshots.
Cada commit (insert, update, delete, merge) genera un nuevo metadata file. El histórico permite time travel y rollback granular.
Ejemplo
Una empresa SaaS guarda eventos de uso en una tabla Iceberg sobre S3:
-- Crear tabla
CREATE TABLE eventos (
    user_id BIGINT,
    evento STRING,
    timestamp TIMESTAMP,
    propiedades MAP<STRING, STRING>
)
USING iceberg
PARTITIONED BY (days(timestamp));

-- Añadir una columna sin reescribir nada
ALTER TABLE eventos ADD COLUMN sesion_id STRING;

-- Consultar el estado tal como estaba hace 24 horas
SELECT COUNT(*) FROM eventos
FOR SYSTEM_VERSION AS OF 1234567890;
La misma tabla la pueden leer al mismo tiempo Spark, Trino, Snowflake, Athena, DuckDB y Dremio porque todos hablan el protocolo Iceberg.
Iceberg v3 (2026)
La especificación v3 incorpora:
- Row lineage: cada fila guarda metadatos sobre su origen y modificaciones.
- Deletion vectors: borrados eficientes sin reescribir los Parquet completos.
- Tipo VARIANT: para datos semiestructurados (JSON-like) consultables sin schema.
- Geospatial types: tipos nativos para datos geográficos.
Iceberg vs Delta Lake vs Hudi
| Iceberg | Delta Lake | Hudi | |
|---|---|---|---|
| Origen | Netflix → ASF | Databricks → Linux Foundation | Uber → ASF |
| Adopción multi-vendor | Muy amplia | Creciendo | Moderada |
| Fortaleza | Evolución de esquema, particionado oculto | Performance, ecosistema Databricks | Upserts, CDC |
El detalle de las opciones de escritura de Hudi —copy on write, merge on read y consultas incrementales— está en su ficha: Apache Hudi.
Tecnologías compatibles
- Motores: Spark, Trino, Flink, Presto, Dremio, DuckDB.
- Plataformas: Snowflake, Databricks (Unity Catalog), AWS Athena, Google BigQuery, Azure Synapse.
- Catálogos: AWS Glue, Hive Metastore, Project Nessie, Polaris (open source de Snowflake), Unity Catalog.
Más información
- Data lakehouse — definición complementaria
- Compara plataformas en el directorio de software de Dataprix.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.