Apache Hudi: qué es y en qué se diferencia de Iceberg y Delta Lake
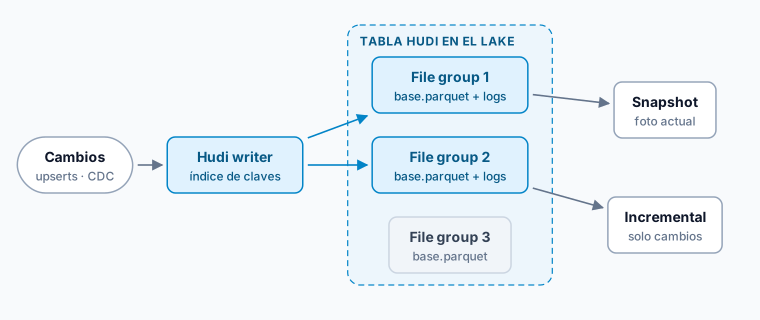
Apache Hudi es un formato de tabla abierto para data lakes que añade transacciones, versionado y —esta es su seña de identidad— actualizaciones y borrados eficientes sobre ficheros que, por naturaleza, no se pueden modificar. Su nombre viene de Hadoop Upserts, Deletes and Incrementals, que resume bastante bien para qué se diseñó.
El problema que resuelve es viejo: en un data lake, los ficheros son inmutables. Cambiar una fila implica reescribir todo el bloque que la contiene. Cuando lo que llega es un flujo continuo de cambios sobre registros existentes, reescribir particiones enteras cada pocos minutos deja de ser viable. Hudi organiza la tabla para que ese caso concreto salga barato.
Las dos formas de guardar una tabla
La decisión de diseño principal en Hudi es el tipo de tabla, y condiciona todo lo demás.
Copy on write. Al aplicar un cambio se reescribe el fichero afectado con las filas ya actualizadas. Escribir cuesta más; leer es tan rápido como leer Parquet plano, porque no hay nada que resolver en el momento de la consulta. Es la opción por defecto cuando la tabla se lee mucho más de lo que se escribe.
Merge on read. Los cambios se anotan aparte, en ficheros de log, y se fusionan con los datos base al consultar o en una compactación posterior. Escribir es mucho más barato y el dato está disponible antes; a cambio, la lectura paga el coste de la fusión mientras no se haya compactado. Es la opción cuando la latencia de ingesta importa más que la latencia de consulta.
No hay que elegir de por vida: la misma tabla merge on read expone vistas distintas —una optimizada para lectura, que ve solo lo compactado, y otra en tiempo casi real, que ve también los logs pendientes—, de modo que cargas distintas pueden consultar el mismo dato con compromisos distintos.
Consultas incrementales
La otra pieza característica es la capacidad de preguntar qué ha cambiado desde un punto determinado en lugar de releer la tabla entera.
Cada escritura genera una versión identificada en la línea temporal de la tabla, y un consumidor puede pedir solo los registros afectados entre dos versiones. Eso convierte la tabla en algo parecido a un flujo de cambios y encaja de forma natural con la ingesta por CDC: los cambios capturados en la base de datos operacional entran en la tabla y salen hacia el modelo analítico sin recorrer todo el histórico en cada pasada.
Sobre esa misma línea temporal se apoya el time travel —consultar la tabla tal como estaba en un instante anterior— y la posibilidad de deshacer una escritura defectuosa volviendo a la versión previa.
Cuándo encaja frente a Iceberg o Delta Lake
Los tres formatos han convergido bastante: los tres dan transacciones, versionado, evolución de esquema y time travel sobre ficheros abiertos, y los tres sirven de base para una arquitectura lakehouse. La elección se decide por el patrón de escritura y por el ecosistema en el que se va a vivir, no por una lista de funcionalidades.
- Hudi parte de la ingesta continua con muchas actualizaciones sobre registros existentes. Trae de serie las herramientas de indexado y compactación que ese caso necesita, y es donde la comparación le favorece.
- Apache Iceberg parte de la tabla analítica grande y de la neutralidad: es el formato con adopción más amplia entre motores de consulta distintos, y su modelo de particionado oculto evita que la organización física del dato se filtre a las consultas.
- Delta Lake parte del ecosistema de Databricks y de la integración estrecha con Spark, aunque también se lee desde otros motores.
Una forma útil de plantearlo: si la tabla se reescribe por lotes y la leen varios motores distintos, la conversación suele acabar en Iceberg; si la tabla recibe un goteo constante de upserts y hay que servir el dato con poco retraso, Hudi es el que fue pensado para eso.
En cualquiera de los tres casos, la decisión de fondo no es el formato sino el particionado y el grano de la tabla, que es lo que de verdad determina el coste de las consultas. El encaje de la capa de almacenamiento en el diseño global está tratado en la guía de arquitectura de datos, y en el directorio de plataformas de datos de Dataprix hay fichas y análisis de los motores que trabajan sobre estos formatos.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.