Data lake: qué es, cuándo conviene y diferencia con data warehouse
Data lake
¿Qué es?
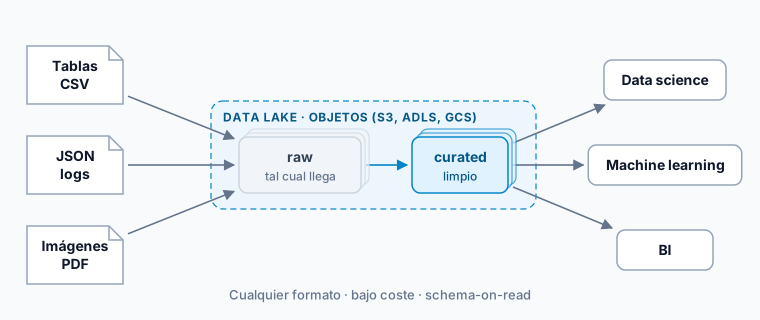
Un data lake (lago de datos) es un repositorio que almacena grandes volúmenes de datos en su formato original, sin transformarlos previamente, sobre almacenamiento de objetos económico (S3, Azure Data Lake Storage, Google Cloud Storage, MinIO).
A diferencia de un data warehouse, donde los datos se cargan ya estructurados y modelados, un data lake acepta cualquier tipo de dato: ficheros CSV, JSON, Parquet, imágenes, vídeos, logs sin formato, telemetría IoT… Cada caso de uso decide cómo leer e interpretar esos datos cuando los necesita (esquema-on-read).
¿Para qué sirve?
- Almacenar datos crudos baratos que quizá se quieran usar en el futuro (logs históricos, telemetría, scrapes).
- Punto de entrada de pipelines ELT modernos: los datos aterrizan tal cual en el lake y se procesan después.
- Fuente para data science y ML: los modelos suelen necesitar datos crudos y de gran granularidad.
- Archivado: cumplimiento legal o de retención sobre datos antiguos que ya no caben en el data warehouse.
Características clave
- Schema-on-read: la estructura se define al consultar, no al cargar. Mucha flexibilidad pero también riesgo de “no saber qué hay”.
- Almacenamiento separado del cómputo: paga storage barato y solo pagas cómputo cuando consultas.
- Formatos abiertos: Parquet, ORC, Avro permiten que múltiples herramientas lean los mismos datos sin lock-in.
- Escala enorme: petabytes son habituales.
Data lake vs data warehouse vs lakehouse
| Data lake | Data warehouse | Lakehouse | |
|---|---|---|---|
| Datos | Crudos, cualquier formato | Estructurados, modelados | Mixto |
| Esquema | On-read | On-write | Mixto |
| Coste storage | Muy bajo (S3, ADLS) | Alto | Muy bajo (igual que lake) |
| Soporte ACID | No nativo | Sí | Sí (Delta, Iceberg, Hudi) |
| Casos de uso | Data science, archivos, ML | BI, reporting | Ambos |
| Riesgo | ”Data swamp” si no se gobierna | Rigidez, coste | Más complejo de operar |
El riesgo: “data swamp”
Sin gobierno, un data lake degenera en “data swamp” (pantano de datos): nadie sabe qué hay, qué tablas son fiables, cuáles están duplicadas, qué se puede usar para qué. Síntomas:
- Cuatro versiones distintas del mismo dato.
- Datos sin documentar y sin propietario.
- Pipelines que dependen de ficheros cuyo origen ya nadie recuerda.
Antídotos:
- Data catalog que indexe y documente lo que hay.
- Convenciones de naming y particionado desde el inicio.
- Data contracts entre productores y consumidores.
- Capas progresivas tipo arquitectura Medallion (bronze/silver/gold).
Tecnologías habituales
- Storage: AWS S3, Azure Data Lake Storage Gen2, Google Cloud Storage, MinIO (open source).
- Formatos: Parquet, Apache Iceberg, Delta Lake, Apache Hudi.
- Procesamiento: Apache Spark, Apache Flink, Databricks, Trino, Dremio, AWS Athena.
- Catalog: AWS Glue, Unity Catalog, Apache Polaris, DataHub.
¿Lake o lakehouse en 2026?
En implantaciones nuevas, el lakehouse es prácticamente el estándar: aprovecha el almacenamiento barato del lake pero añade ACID, gobierno y rendimiento de DW gracias a formatos como Delta Lake o Iceberg. Construir un data lake “puro” sin esas garantías es cada vez menos común y más arriesgado.
Más información
- Data lakehouse — definición
- Data warehouse — definición
- Arquitectura Medallion — definición
- Almacenamiento de datos: data lakes, data warehouses y lakehouses — capítulo de la guía práctica de arquitectura de datos de Dataprix.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.