Schema-on-read: qué es y en qué se diferencia de schema-on-write
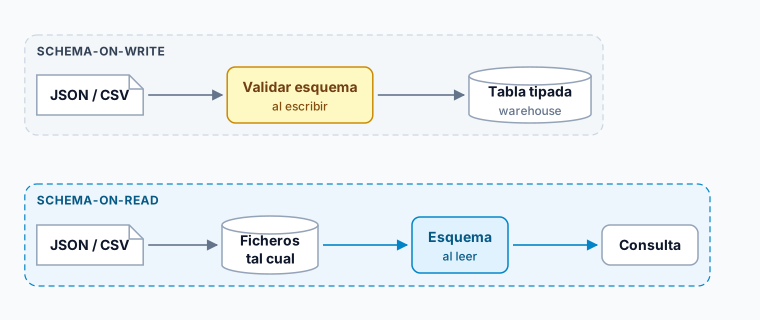
Schema-on-read es el enfoque en el que los datos se almacenan tal como llegan y la estructura —los nombres de campo, los tipos, las restricciones— se aplica en el momento de leerlos. Lo contrario es schema-on-write: definir el esquema por adelantado y rechazar en la escritura todo lo que no encaje.
La diferencia no está en si hay esquema o no. Siempre lo hay: alguien tiene que saber que la tercera columna es una fecha. Lo que cambia es cuándo se comprueba y quién asume el coste de que esté mal.
Dónde aparece cada enfoque
El data warehouse clásico es schema-on-write. Las tablas se declaran antes de cargar nada y el proceso de carga falla si el dato no cumple. Esa rigidez es justamente su valor: quien consulta la tabla sabe lo que va a encontrar.
El data lake popularizó el enfoque contrario. Se vuelcan ficheros en el almacenamiento —logs, exportaciones, respuestas de API— sin decidir de antemano su forma, y cada consumidor interpreta lo que necesita cuando lo necesita.
Qué se gana
El argumento a favor de schema-on-read es real y conviene no despacharlo:
- No hay que anticipar preguntas. Si dentro de dos años alguien quiere analizar un campo que hoy nadie mira, el campo está ahí. En schema-on-write, lo que no se modeló al principio se descartó en la carga y no se recupera.
- Ingesta más barata y más rápida. No hay que negociar un modelo antes de traer una fuente nueva. Para datos de estructura irregular o cambiante, evita rehacer la tubería cada vez.
- Absorbe cambios en origen. Cuando una aplicación añade un campo, el proceso no se rompe. Enlaza con lo que se explica en evolución de esquema.
Qué se traslada
Lo que no desaparece es el trabajo de dar forma al dato: se mueve del equipo que ingesta al equipo que consulta, y se multiplica por el número de consumidores.
- Cada consulta reinterpreta. Si cinco análisis leen el mismo fichero, cinco personas deciden por separado qué significa cada campo. Basta con que dos lo hagan distinto para que dos informes den cifras diferentes con el mismo dato de partida.
- Los errores aparecen tarde. Un tipo incorrecto que schema-on-write habría rechazado en la carga sale a la luz meses después, durante un análisis, cuando ya nadie recuerda el contexto.
- Sin disciplina, el lago se opaca. El caso clásico es el data lake que acumula ficheros que nadie sabe leer. La calidad del dato y el catálogo dejan de ser recomendables y pasan a ser condición para que el enfoque funcione.
El punto intermedio
En la práctica pocas arquitecturas eligen un extremo. Lo habitual es aplicar schema-on-read en la zona de aterrizaje, donde el dato entra crudo, y schema-on-write a partir del momento en que se publica para consumo analítico. Es el reparto que estructura la arquitectura medallion y el que adopta el lakehouse, donde el formato de tabla impone tipos y transacciones sobre ficheros que siguen viviendo en un almacenamiento de objetos.
Los formatos de fichero columnar contribuyen a difuminar la frontera. Un fichero Parquet lleva el esquema escrito dentro, así que el lector no tiene que adivinarlo aunque nadie declarase una tabla: hay esquema sin haber pasado por un modelo previo.
Cómo decidir
La pregunta útil no es cuál es mejor, sino cuántos consumidores va a tener ese dato.
Para un conjunto que explora una persona con una pregunta concreta, schema-on-read ahorra trabajo inútil. Para un dato que alimenta informes de los que dependen decisiones, el coste de no haber fijado el esquema se paga tantas veces como consultas haya, y el orden de magnitud deja de compensar.
Un criterio complementario es la estabilidad del origen: cuanto más cambia la fuente, más caro resulta mantener un esquema rígido en la entrada.
Cómo encaja esta decisión con el resto del diseño —zonas, formatos y gobierno del dato— está desarrollado en la guía de arquitectura de datos de Dataprix. Para comparar cómo resuelve cada motor la gestión del esquema, el directorio de plataformas de datos recoge fichas y análisis editorial de las principales opciones.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.