Data catalog: qué es y por qué es imprescindible al escalar datos
Data catalog
¿Qué es?
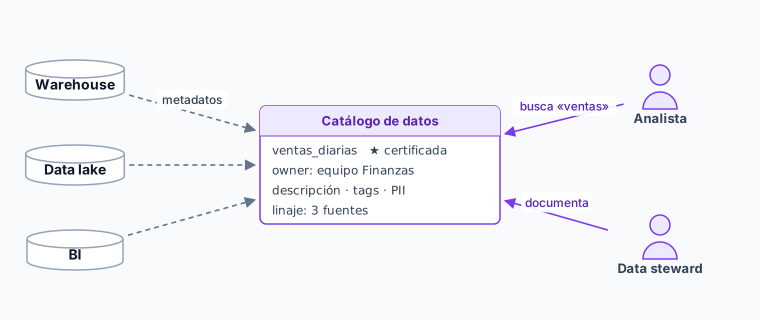
Un data catalog (catálogo de datos) es un inventario centralizado y navegable de los activos de datos de una organización. Indexa qué tablas, ficheros, dashboards y modelos existen, dónde están, quién los mantiene, qué significan y cómo se usan.
Pensado para responder preguntas como:
- “¿Tenemos en algún sitio la tabla de clientes activos?”
- “¿De dónde viene este KPI de revenue?”
- “¿Quién es el dueño de este dataset y puedo confiar en él?”
- “Si cambio esta columna, ¿qué dashboards se rompen?”
¿Para qué sirve?
A medida que una organización tiene más fuentes y más usuarios analizando datos, encontrar y entender lo que hay se vuelve un cuello de botella. Sin catálogo:
- Cada equipo construye su propia versión del mismo dato.
- Nadie sabe qué es fiable y qué no.
- Cambios técnicos rompen consumos invisibles aguas abajo.
- Los nuevos analistas tardan meses en orientarse.
Un buen data catalog responde a estos tres ejes:
1. Descubrimiento
Buscador estilo Google: “ventas por país” → te lista las tablas, dashboards y modelos disponibles que tratan ese tema.
2. Contexto
Ficha de cada activo con:
- Descripción funcional (qué representa).
- Esquema (columnas y tipos).
- Propietario y mantenedor.
- Calidad medida (frescura, completitud, validez).
- Frecuencia de actualización.
- Tags y clasificaciones (PII, regulado, sensible).
3. Linaje (data lineage)
Grafo de dependencias: de qué tablas viene cada tabla, qué dashboards y modelos consumen una tabla concreta. Imprescindible para evaluar el impacto de cualquier cambio.
Ejemplo
Una analista nueva en la empresa entra al data catalog y busca “MRR”:
- Encuentra la métrica en el dashboard “Finanzas Q1” pero también en otro llamado “Suscripciones”.
- Mira el linaje: ambos vienen de la tabla
gold.metrics_monthly, que se calcula en dbt desdesilver.subscriptions, que viene de Stripe vía Fivetran. - Ve que la propietaria es Marta de Finance, marcada como “verified” y con freshness ≤24h.
- Tiene la información completa antes de mover un dedo: a quién preguntar, en qué confiar y cómo está calculado.
Tecnologías de referencia
Comerciales / SaaS:
- Atlan, Collibra, Alation — referentes empresariales.
- Microsoft Purview — fuerte en stack Microsoft.
- Informatica IDMC — opción enterprise tradicional.
Open source / cloud-native:
- DataHub (LinkedIn) — open source, popular.
- OpenMetadata — open source, ecosistema activo.
- Apache Atlas — Hadoop-era, sigue vigente en stacks Hadoop.
Integrados en plataformas:
- Unity Catalog (Databricks).
- Apache Polaris (Snowflake).
- AWS Glue Data Catalog.
Cuándo te hace falta uno
Indicadores claros:
- Tienes >5 fuentes de datos diferentes.
- Más de 10 personas consultan el data warehouse.
- Has tenido al menos un incidente “este número no cuadra entre dashboards”.
- Cada cambio de esquema en una tabla causa caos aguas abajo.
- Te has dado cuenta de que tienes 3 versiones del mismo dato.
Si te identificas con dos o más, ya lo necesitas.
Más información
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.