Data lineage: qué es, para qué sirve y ejemplo práctico
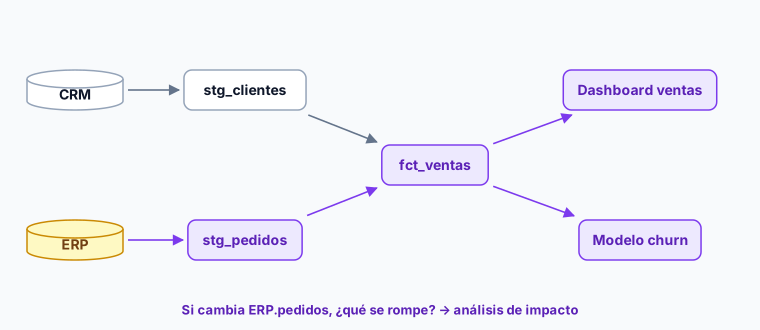
Data lineage
¿Qué es?
Data lineage (linaje de datos) es la capacidad de rastrear el recorrido completo de un dato desde su origen hasta su uso final: por qué sistemas pasa, qué transformaciones sufre, qué pipelines lo procesan y en qué dashboards, modelos o decisiones acaba.
Visualmente se representa como un grafo dirigido: nodos = tablas/columnas/ficheros/modelos, aristas = transformaciones (jobs ETL, queries, modelos dbt, scripts Python).
Para qué sirve
- Análisis de impacto: si se va a modificar una tabla origen, qué dashboards y modelos quedarán afectados.
- Debugging: cuando un KPI da un valor extraño, recorrer el linaje aguas arriba hasta encontrar la fuente del problema.
- Cumplimiento regulatorio: el AI Act, RGPD, DORA y otros marcos exigen demostrar de dónde vienen los datos y cómo se han procesado, especialmente en sistemas de IA de alto riesgo.
- Confianza en los datos: los consumidores saben quién es el dueño del dato y qué pipelines lo mantienen.
- Optimización de costes: identificar tablas que nadie consume aguas abajo para retirarlas.
Niveles de granularidad
Hay tres niveles habituales, de menos a más fino:
- A nivel de tabla: la tabla
pedidos_diariosderiva depedidos_rawyclientes. - A nivel de columna: la columna
total_facturase calcula comocantidad * precio_unitario * (1 + iva)a partir de tres columnas concretas. - A nivel de fila: cada fila individual lleva metadatos de origen (cuándo entró, qué proceso la generó, qué versión del modelo dbt la calculó). Iceberg v3 incorpora esto con el atributo row lineage.
Granularidades más finas son más útiles pero más caras de mantener.
Ejemplo
El equipo de finanzas detecta que el dashboard de margen mensual muestra un valor anómalo en una región concreta.
- Abrir el linaje del KPI en la herramienta de catálogo.
- Ver aguas arriba: el dashboard consume la tabla
margenes_region, alimentada por un modelo dbtfct_margenes, que uneventas_dimconcostes_dim. - Detectar la anomalía:
costes_dimrecibió un nuevo flujo CSV desde un SAP recién migrado que duplicaba ciertas filas. - Resolver: corregir el pipeline de ingestion y reprocesar el modelo. El linaje confirma qué dashboards hay que refrescar tras el arreglo.
Sin linaje, este debugging habría requerido horas de revisión manual entre departamentos.
Cómo se construye
Dos enfoques no mutuamente excluyentes:
- Parsing automático de SQL y código: herramientas como dbt, Dataform, OpenLineage o Atlan analizan las queries y los DAG para inferir el linaje sin que nadie lo declare.
- Declaración manual: para sistemas legacy o procesos no introspectables (scripts shell, exports manuales), el linaje se documenta a mano en el catálogo.
Las plataformas modernas combinan ambos: parsing automático donde se puede + declaración manual para llenar huecos.
OpenLineage
OpenLineage es el estándar abierto de la Linux Foundation para emitir eventos de linaje desde cualquier sistema. Soportado nativamente por Airflow, dbt, Spark, Flink y muchos catálogos comerciales. Permite que el linaje no quede atrapado en una plataforma propietaria.
Tecnologías de referencia
- Catálogos con linaje integrado: Atlan, Collibra, Alation, DataHub, OpenMetadata, Informatica, Microsoft Purview.
- Standalone open source: Marquez (implementación de referencia de OpenLineage), Apache Atlas.
- Capa de transformación con linaje nativo: dbt (lineage de modelos), SQLMesh.
Más información
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.