Enmascaramiento de datos: qué es y cuándo no basta con anonimizar
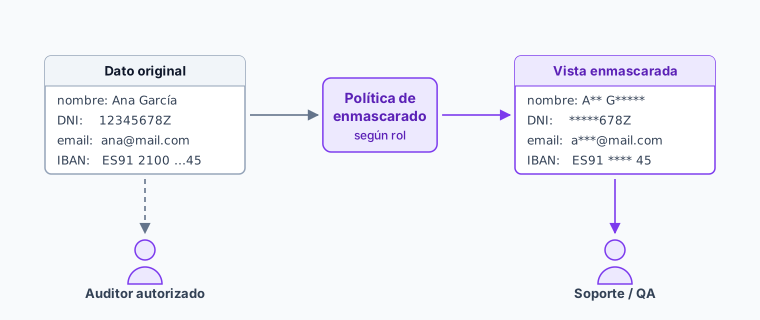
El enmascaramiento de datos consiste en sustituir valores sensibles por otros ficticios que conservan el formato y el comportamiento del original. Un DNI sigue pareciendo un DNI y un IBAN sigue validando, pero no corresponden a nadie real.
El objetivo no es cifrar: es que el dato siga sirviendo para trabajar sin exponer a la persona que hay detrás. Un entorno de pruebas necesita nombres que ocupen lo que ocupan los nombres y fechas que se comporten como fechas; con un campo cifrado, la aplicación no funciona y las pruebas no valen.
Tres conceptos que se confunden
Se usan como sinónimos y no lo son. La distinción importa porque determina qué obligaciones siguen aplicando sobre el dato resultante:
- Seudonimización. El identificador se sustituye por un código, y existe en algún sitio la tabla que permite deshacer la sustitución. El dato sigue siendo personal y sigue estando sujeto a la normativa de protección de datos: se ha reducido el riesgo, no se ha eliminado.
- Anonimización. La reidentificación es irreversible. Bien hecha, el resultado deja de ser dato personal. Es un listón alto, y ahí está la trampa que se explica más abajo.
- Enmascaramiento. La técnica concreta de sustituir valores. Según cómo se aplique, produce un resultado seudonimizado o anonimizado. Es un medio, no una categoría legal.
Técnicas habituales
Sustitución. Cambiar el valor por otro de un catálogo verosímil: nombres reales por nombres de una lista. Mantiene el aspecto y la longitud.
Mezcla (shuffling). Reordenar los valores de una columna entre las filas. Los datos siguen siendo reales en conjunto pero no corresponden a la fila donde están. Barato, y con una debilidad conocida: los agregados por esa columna se conservan intactos.
Enmascaramiento parcial. Ocultar una parte y dejar el resto visible, como se hace con los últimos dígitos de una tarjeta. Útil cuando el fragmento visible basta para el caso de uso.
Perturbación. Alterar valores numéricos con un ruido acotado. Conserva las distribuciones aproximadas y destruye el valor individual. Es lo razonable para importes, edades o consumos.
Enmascaramiento dinámico. No se altera el dato almacenado: se enmascara al vuelo según quién consulta. Evita duplicar conjuntos, pero traslada toda la responsabilidad al control de acceso, que pasa a ser el único punto de fallo.
El error clásico: creer que quitando el nombre ya está
La reidentificación no necesita el nombre. Necesita combinar campos que por separado parecen inofensivos. Un código postal, una fecha de nacimiento y un sexo bastan para singularizar a una proporción sorprendente de la población de un municipio pequeño. Añadir la profesión o la fecha de alta suele acabar el trabajo.
De ahí que un conjunto «anonimizado» quitando identificadores directos siga siendo, en muchos casos, dato personal en la práctica. Las salidas habituales son reducir la granularidad —año en lugar de fecha exacta, provincia en lugar de código postal— o agrupar hasta que ninguna combinación identifique a menos de un número mínimo de personas.
Esa comprobación conviene hacerla sobre el conjunto real antes de considerarlo anónimo, porque depende por completo de los datos que haya: la misma transformación puede ser suficiente en un conjunto y no serlo en otro.
Dónde encaja en la arquitectura
El enmascaramiento no es una tarea aislada: depende de saber qué campos son sensibles y dónde están. Eso lo aporta el catálogo de datos, y el linaje responde a la pregunta siguiente, que es la que suele fallar: por dónde se ha copiado ese campo. Un conjunto de pruebas enmascarado no sirve de nada si el mismo dato viaja sin enmascarar a un fichero de exportación que nadie inventarió.
Lo razonable es aplicarlo en el punto donde el dato sale del entorno productivo hacia cualquier otro —pruebas, análisis, un tercero—, y dejar constancia de qué transformación se aplicó a cada campo, porque quien reciba el conjunto necesita saber qué puede y qué no puede concluir de él. Es información que encaja en el contrato de datos del conjunto.
El encaje del gobierno del dato en el diseño global de una plataforma está desarrollado en la guía de arquitectura de datos de Dataprix. Para comparar herramientas de la categoría, el directorio de gobernanza de datos recoge fichas y análisis editorial.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.