Formato de tabla abierto: qué es y por qué lo necesita un lakehouse
Formato de tabla abierto
¿Qué es?
Un formato de tabla abierto (open table format) es una especificación pública que convierte un conjunto de ficheros de datos guardados en almacenamiento de objetos en algo que se comporta como una tabla: con esquema, transacciones y versiones.
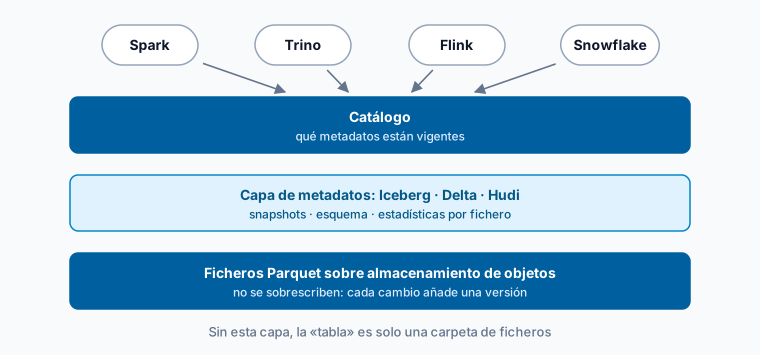
No sustituye al formato de los ficheros. Los datos siguen en Parquet u otro formato columnar; lo que añade el formato de tabla es una capa de metadatos que registra qué ficheros forman la tabla en cada momento, qué columnas tiene y qué estadísticas hay de cada fichero. Que sea abierto significa dos cosas: la especificación está publicada y varios motores de consulta distintos pueden leer y escribir la misma tabla sin pedir permiso a un fabricante.
El problema que resuelve
Antes de esta capa, una “tabla” en un data lake era una carpeta con ficheros Parquet dentro. Eso funciona para leer, y falla en todo lo demás:
- No hay transacciones. Si un proceso reescribe la carpeta mientras otro la lee, el lector ve un estado a medias. No hay forma de hacer que un cambio sea visible de golpe o no serlo.
- No se puede borrar ni actualizar una fila sin reescribir el fichero completo que la contiene, y averiguar cuál es exige abrirlos todos.
- Listar la carpeta es la única forma de saber qué hay. Con decenas de miles de ficheros, el motor tarda más en enumerarlos que en leer los datos.
- El esquema es una convención, no un contrato: si alguien escribe un fichero con una columna renombrada, el error aparece meses después en una consulta.
Qué aporta
Los tres formatos de referencia funcionan con la misma idea de fondo —no se sobrescribe, se añade una versión nueva y se actualiza el puntero de metadatos— y de ahí salen sus capacidades:
- Transacciones ACID sobre almacenamiento de objetos: un cambio se ve completo o no se ve.
UPDATE,DELETEyMERGEpor clave, sin reescribir la tabla entera.- Time travel: consultar la tabla tal como estaba en una versión anterior, que es también la forma de deshacer una carga mal hecha.
- Evolución de esquema: añadir, renombrar o retipar columnas sin reescribir el histórico y sin romper a quien ya consulta.
- Lectura eficiente: las estadísticas por fichero permiten descartar la mayoría de ellos antes de abrirlos, en vez de recorrer la carpeta.
- Esquema de particionado desacoplado: se puede cambiar cómo se particiona la tabla sin mover los datos existentes ni cambiar las consultas.
Los tres de referencia
| Origen | Rasgo distintivo | |
|---|---|---|
| Apache Iceberg | Netflix | Diseño por capas (catálogo → metadatos → manifests) y el más neutral en cuanto a motores |
| Delta Lake | Databricks | Log de transacciones ordenado; muy integrado con el ecosistema Spark |
| Apache Hudi | Uber | Índice de claves propio, pensado desde el principio para upserts frecuentes |
Las diferencias prácticas entre los tres se han ido estrechando. A efectos de decisión pesa más qué motores y qué catálogo usa ya la organización que las capacidades de la especificación.
El catálogo es parte del montaje
Un detalle que suele sorprender: el formato de tabla dice cómo están organizados los metadatos, pero alguien tiene que saber dónde está el fichero de metadatos vigente de cada tabla. Ese registro es el catálogo, y es la pieza que hace que dos motores distintos vean la misma tabla y no dos copias desincronizadas. Sin catálogo compartido, el formato abierto sigue siendo abierto pero la interoperabilidad no se materializa.
Donde encaja
Es la capa intermedia de un data lakehouse: almacenamiento de objetos abajo, formato de tabla en medio, motores de consulta arriba. También es lo que hace viable que un data lake deje de ser solo zona de aterrizaje y sirva consultas analíticas serias.
Cuándo no hace falta
Si los datos caben en un data warehouse y nadie necesita leerlos desde varios motores, esta capa añade operación sin resolver un problema que se tenga. Tiene un coste real: hay que programar el mantenimiento desde el principio, porque escribir versiones en vez de sobrescribir deja miles de ficheros pequeños que degradan las consultas y se corrigen con compactación de ficheros.
Más información
- Almacenamiento de datos: data lakes, data warehouses y lakehouses — capítulo de la guía práctica de arquitectura de datos de Dataprix.
- Compara plataformas de datos en el directorio de software de Dataprix.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.