Apache Hadoop: qué es y para qué sirve
Apache Hadoop
¿Qué es?
Apache Hadoop es un marco de código abierto para almacenar y procesar grandes volúmenes de datos de forma distribuida sobre agrupaciones (clusters) de máquinas corrientes. Fue la tecnología que popularizó el concepto de big data: en lugar de comprar un servidor gigante, repartes los datos y el cómputo entre muchos ordenadores baratos que trabajan en paralelo.
Su idea fundacional —llevar el cálculo a donde están los datos, en vez de mover los datos hacia el cálculo— marcó el diseño de buena parte de las plataformas de datos que vinieron después.
Componentes principales
El núcleo de Hadoop se apoya en tres piezas:
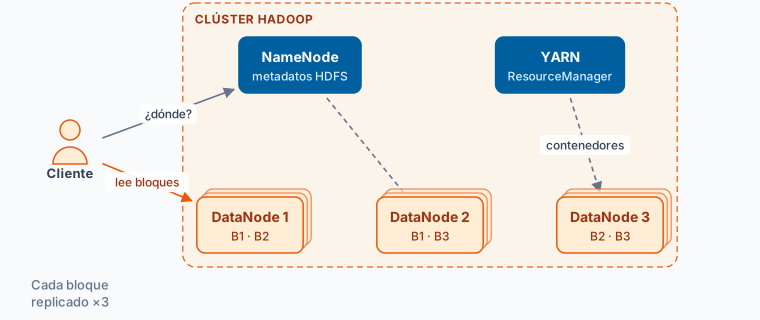
- HDFS (Hadoop Distributed File System): un sistema de ficheros distribuido que parte los archivos en bloques y los reparte —con réplicas— entre los nodos del cluster. Así se toleran fallos de máquinas sin perder datos.
- MapReduce: el modelo de programación original para procesar esos datos en paralelo, dividiendo el trabajo en una fase de map (transformar) y otra de reduce (agregar).
- YARN: el gestor de recursos que reparte capacidad de cómputo entre los trabajos que corren en el cluster.
Alrededor de este núcleo creció un amplio ecosistema de herramientas para consulta, ingesta y coordinación.
Para qué sirve
- Almacenar datos a gran escala de forma económica y tolerante a fallos.
- Procesar conjuntos masivos que no caben ni se procesan en una sola máquina.
- Servir de base a un data lake sobre hardware distribuido.
Hadoop hoy
MapReduce, el motor de procesamiento original, ha quedado en gran medida desplazado por alternativas más rápidas en memoria como Apache Spark, que puede ejecutarse sobre datos de un cluster Hadoop. Aun así, las ideas de Hadoop —almacenamiento distribuido, procesamiento en paralelo y tolerancia a fallos— siguen siendo la base conceptual de la ingeniería de datos moderna.
Más información
- Apache Spark — el motor que sustituyó a MapReduce en la mayoría de casos
- Data lake — el repositorio de datos que Hadoop ayudó a popularizar
- Apache Parquet — formato columnar habitual sobre almacenamiento distribuido
Para situar estas tecnologías dentro de una arquitectura concreta, el directorio de plataformas de datos de Dataprix recoge fichas y análisis de cada opción.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.