Apache Kafka: qué es y para qué sirve en arquitecturas de datos
Apache Kafka
¿Qué es?
Apache Kafka es una plataforma distribuida de streaming de eventos de código abierto, diseñada para publicar, almacenar y procesar flujos de mensajes en tiempo real con alta tolerancia a fallos. Nació en LinkedIn en 2011 y hoy es el estándar de facto para mover datos entre sistemas de forma continua, en lugar de hacerlo en lotes nocturnos. Funciona como un registro de eventos duradero y ordenado al que unas aplicaciones escriben (productores) y otras leen (consumidores) de forma desacoplada.
Cómo funciona
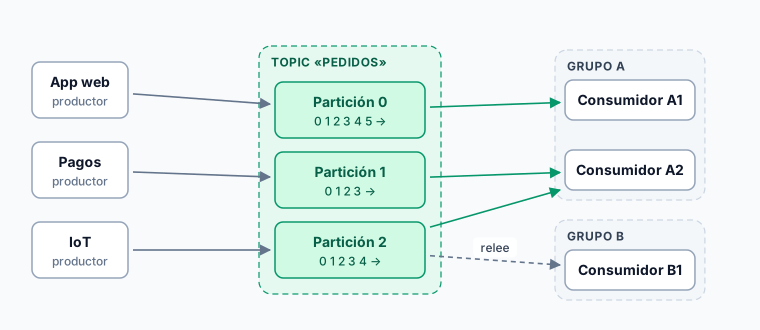
El modelo de Kafka se apoya en cuatro conceptos:
- Evento (o mensaje): un registro con clave, valor y timestamp. Representa “algo que ha pasado”: una compra, un clic, una lectura de sensor.
- Topic: la categoría a la que se publican los eventos. Es como una tabla append-only: solo se añaden registros, nunca se modifican.
- Partición: cada topic se divide en particiones que permiten paralelizar y escalar. Dentro de una partición el orden está garantizado.
- Broker: cada servidor del clúster Kafka. Varios brokers replican las particiones entre sí para que la caída de uno no pierda datos.
A diferencia de una cola tradicional, Kafka retiene los eventos durante un periodo configurable (horas, días o indefinidamente). Esto permite que un consumidor reprocese el histórico desde el principio, algo clave para reconstruir estados o alimentar sistemas nuevos.
Para qué sirve
Kafka es la columna vertebral de muchas arquitecturas de datos modernas:
- Pipelines en tiempo real: transportar eventos desde aplicaciones operativas hacia el data warehouse o lakehouse según se producen.
- Integración de sistemas: desacoplar microservicios para que se comuniquen por eventos sin llamadas directas entre ellos.
- Captura de cambios (CDC): combinado con conectores como Debezium, propaga cambios de bases de datos operativas hacia analítica casi al instante.
- Procesamiento de streams: con Kafka Streams o ksqlDB se transforman y agregan datos en vuelo, sin esperar a un batch.
- Telemetría y logs: centralizar métricas, trazas y eventos de aplicaciones a gran escala.
Kafka frente a alternativas
Kafka no es la única opción de mensajería. RabbitMQ o ActiveMQ encajan mejor en colas de tareas con baja latencia y enrutamiento complejo. Kafka destaca cuando importa el throughput masivo, la retención del histórico y la reproducción de eventos. En la nube hay equivalentes gestionados como Amazon Kinesis, Google Pub/Sub o Azure Event Hubs, además del propio Kafka gestionado (Confluent Cloud, Amazon MSK).
Limitaciones y consideraciones
- Complejidad operativa: un clúster Kafka autogestionado exige conocimiento de replicación, particionado y retención. Por eso muchas empresas optan por versiones gestionadas.
- No es una base de datos: Kafka mueve y retiene eventos, pero no sustituye a un almacén consultable de forma arbitraria.
- Diseño de claves y particiones: una mala elección de clave de partición rompe el orden o desequilibra la carga.
Más información
- CDC — captura de cambios que suele viajar sobre Kafka
- Data streaming — el paradigma que Kafka materializa
- Event sourcing — el patrón de diseño que convierte los eventos en la fuente de verdad
- Reverse ETL — devolver datos analíticos a sistemas operativos
- Airflow, Prefect, dbt, NiFi y Kafka: comparativa práctica — capítulo de la guía práctica de arquitectura de datos de Dataprix.
- Ver plataformas de integración en el directorio de Dataprix.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.