Data Streaming: qué es el procesamiento en tiempo real de datos
Data Streaming
¿Qué es?
Data streaming (o stream processing) es la capacidad de procesar y analizar datos en el instante en que se generan, evento a evento, sin esperar a que se acumule un lote. Frente al procesamiento batch, donde los datos se recogen durante un periodo (horas, días) y se procesan todos juntos, el streaming trata cada evento de forma individual o en microventanas de tiempo muy cortas (milisegundos a segundos).
El resultado es que el sistema puede reaccionar a lo que ocurre ahora mismo, no a lo que ocurrió ayer.
Batch vs. Streaming: cuándo importa la diferencia
| Batch | Streaming | |
|---|---|---|
| Latencia | Minutos a horas | Milisegundos a segundos |
| Volumen por ejecución | Grande (miles/millones de registros) | Pequeño (uno o pocos eventos) |
| Complejidad operacional | Baja | Alta |
| Casos de uso típicos | Informes diarios, ETL nocturno, ML training | Detección de fraude, alertas, IoT, chat en tiempo real |
| Coste computacional | Más predecible | Más variable |
La mayoría de sistemas de datos modernos usan ambos: streaming para reaccionar en tiempo real y batch para análisis histórico y cargas pesadas.
La arquitectura básica del streaming
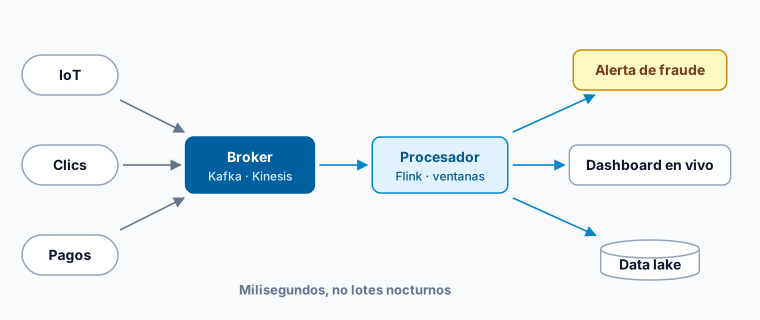
Un pipeline de streaming tiene tres piezas:
- Productor: el sistema que genera eventos (aplicación web, sensor IoT, base de datos con CDC).
- Broker / Cola de mensajes: almacena y distribuye los eventos. Aquí entra Apache Kafka, el estándar de facto.
- Consumidor / Procesador: lee los eventos y aplica lógica (filtros, agregaciones, joins, alertas).
Fuente de eventos → [Kafka] → Procesador (Flink/Spark Streaming) → Destino
                                                                    (BD, DW, dashboard)
Apache Kafka
Kafka es la plataforma de streaming de eventos más usada. Su modelo:
- Los eventos se publican en topics (equivalente a tablas, pero para flujos).
- Los productores escriben en topics; los consumidores leen de topics.
- Los eventos se retienen durante un periodo configurable (días, semanas), lo que permite reprocessar histórico y tener múltiples consumidores independientes.
- Es distribuido y tolerante a fallos por diseño.
Kafka no procesa por sí solo: es el canal de transporte. Para procesar los eventos se usa un framework como Apache Flink (procesamiento stateful complejo), Apache Spark Streaming (más integrado con el batch de Spark) o ksqlDB (SQL sobre Kafka para casos sencillos).
Casos de uso reales
Detección de fraude en tiempo real: una entidad bancaria procesa cada transacción con tarjeta y la puntúa contra un modelo de ML antes de que la operación se autorice (latencia < 200ms).
IoT industrial: sensores de una línea de producción envían métricas cada segundo; el sistema detecta anomalías y lanza alertas antes de que ocurra un fallo.
Personalización web: cuando un usuario hace clic en un producto, el evento se procesa en tiempo real para actualizar sus recomendaciones en la misma sesión.
Change Data Capture (CDC): los cambios en una base de datos transaccional (CDC) se envían a Kafka, permitiendo que el data warehouse esté actualizado en segundos en lugar de esperar al ETL nocturno.
Complejidad y cuándo NO es necesario
El streaming introduce complejidad operacional significativa:
- Gestionar un cluster Kafka requiere experiencia.
- El procesamiento stateful (aggregaciones con ventanas de tiempo, joins entre streams) es conceptualmente más difícil que SQL batch.
- Debugging y testing de pipelines de streaming son más complejos.
Regla práctica: si no necesitas reaccionar en menos de 15-30 minutos, un pipeline batch bien diseñado es más simple y más barato. El streaming se justifica cuando la latencia importa al negocio, no como ejercicio tecnológico.
Más información
- Eventos vs batch: los fundamentos de la integración de datos — capítulo de la guía práctica de arquitectura de datos de Dataprix.
- Explora herramientas de ingeniería de datos en el directorio de Dataprix.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.