CDC (Change Data Capture): qué es y cómo replicar datos en tiempo real
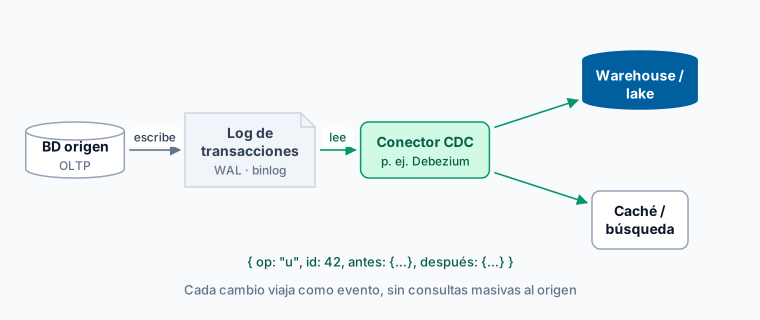
CDC (Change Data Capture)
¿Qué es?
CDC (Change Data Capture, captura de cambios) es la técnica de detectar los cambios (inserts, updates, deletes) que ocurren en una base de datos operativa y propagarlos a otro sistema —típicamente analítico— en tiempo casi real, sin sobrecargar la base origen.
Es la alternativa moderna al clásico “extracción nocturna por lotes”: en vez de leer toda la tabla cada noche, CDC captura solo lo que ha cambiado.
¿Para qué sirve?
- Alimentar data warehouses y data lakes en tiempo casi real: latencias de segundos o minutos en vez de horas.
- Sincronizar bases de datos entre sistemas (replicación primary-replica, multi-cloud).
- Eventos de negocio: emitir mensajes a Kafka cuando algo cambia en el ERP/CRM, para que otros sistemas reaccionen.
- Migraciones de bases de datos sin downtime: la nueva BD se mantiene sincronizada con la antigua durante la migración.
Métodos de CDC
1. Lectura del transaction log (el bueno)
El método óptimo. La BD operativa escribe todos los cambios en un log de transacciones (binlog en MySQL, WAL en PostgreSQL, redo log en Oracle, transaction log en SQL Server). CDC lee ese log y emite eventos.
- ✅ Mínima carga en la BD origen.
- ✅ Captura inserts, updates y deletes.
- ✅ Latencia muy baja.
- ❌ Requiere permisos de lectura del log.
Herramientas: Debezium, Fivetran, AWS DMS, Oracle GoldenGate.
2. Triggers en BD
Triggers que registran los cambios en una tabla auxiliar.
- ✅ Funciona en BDs que no exponen log.
- ❌ Penalización de rendimiento.
- ❌ Hay que mantener triggers en cada tabla.
3. Polling por timestamp
Consultas tipo WHERE updated_at > last_run.
- ✅ Simple de implementar.
- ❌ No captura DELETEs sin marca lógica.
- ❌ Requiere columna
updated_atfiable en cada tabla. - ❌ Carga extra en la BD origen en cada poll.
Ejemplo
Un retailer quiere ver el stock en tiempo real en su dashboard ejecutivo. El stock vive en su ERP (Oracle):
- Debezium se conecta al redo log de Oracle y emite cada cambio de la tabla
STOCKcomo un evento Kafka. - Un consumidor escribe esos eventos en
bronze.stock_changesdel data lakehouse (Snowflake con Iceberg). - dbt ejecuta cada minuto un modelo incremental que actualiza
gold.stock_actual. - El dashboard de Power BI consulta
gold.stock_actualy se refresca cada 60 segundos.
Latencia total origen→dashboard: ~30-90 segundos. Sin sobrecarga sobre el ERP.
CDC con Kafka — el patrón habitual
Oracle/Postgres/MySQL → Debezium → Apache Kafka → Sinks (Snowflake, S3, Elasticsearch...)
Kafka actúa como buffer durable: si el destino cae, los eventos no se pierden. Si conectas un consumidor nuevo después, puedes reproducir todo el histórico.
Cuándo NO usar CDC
La pregunta previa no es técnica: es cuánto retraso tolera de verdad quien consume el dato. Ese número es el SLA de datos de la tabla, y es lo que debería decidir entre CDC y un proceso por lotes. Sin ese número escrito, la decisión la acaba tomando la moda tecnológica, y el coste no se paga el día de la instalación: se paga cada vez que hay que mantenerlo.
- Cargas analíticas que toleran latencia diaria → ELT por lotes es más simple.
- Volúmenes pequeños → la complejidad operativa no compensa.
- BDs donde no puedes acceder al log y los triggers no son viables.
No confundir con event sourcing
Ambos producen un flujo de cambios, pero el CDC observa desde fuera una base de datos que sobrescribe su estado, y por eso se puede añadir a un sistema existente sin tocarlo. En event sourcing los eventos son la forma primaria en que la aplicación guarda las cosas, lo que da un flujo mucho más rico —describe intenciones de negocio, no cambios de filas— a cambio de tener que diseñarlo así desde el principio.
Qué vigilar una vez montado
Un pipeline de CDC parado no se nota. Lo que lo detecta es medir la frescura de datos de la tabla destino, no la salud del proceso.
Y si el destino es un lakehouse, para consultar estados pasados no hace falta pedirle nada al CDC: eso lo resuelve el time travel del propio formato de tabla.
Ese mismo destino trae una tarea de mantenimiento que conviene programar desde el primer día: como cada tanda de cambios escribe ficheros nuevos, una replicación continua acaba dejando miles de ficheros diminutos que degradan las consultas. Se corrige con compactación de ficheros.
Más información
- Eventos vs batch: los fundamentos de la integración de datos — capítulo de la guía práctica de arquitectura de datos de Dataprix.
- Compara herramientas de integración de datos en el directorio de Dataprix.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.