Replicación de datos: qué es, métodos y diferencia con un ETL
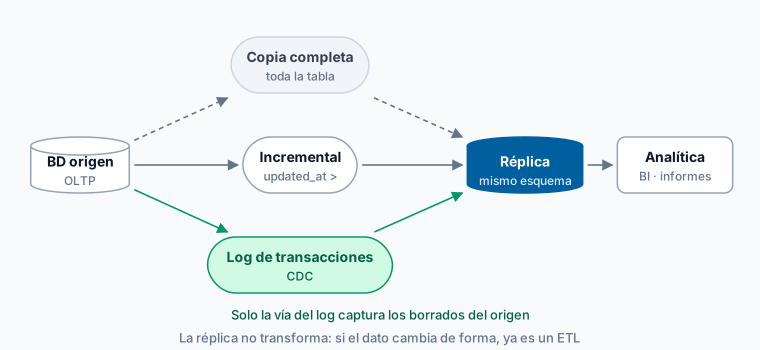
Replicación de datos
¿Qué es?
La replicación de datos es el proceso de mantener una copia fiel de unos datos en un sistema distinto del original, y de mantenerla al día cuando el original cambia.
La palabra importante es fiel. Lo que distingue la replicación de un proceso de integración cualquiera es que el objetivo es la equivalencia con el origen, no la mejora: las mismas tablas, las mismas columnas, los mismos valores. Si al llegar al destino el dato se ha limpiado, unido con otro o agregado, eso ya no es replicación.
Para qué se usa
- Alimentar el entorno analítico sin que las consultas pesadas golpeen la base de producción. Es el caso más común: una réplica del OLTP desde la que leer libremente.
- Alta disponibilidad y recuperación: si el nodo principal cae, una réplica puede asumir el servicio.
- Acercar el dato al usuario: copias en distintas regiones para reducir latencia.
- Migraciones sin parada: el sistema nuevo se mantiene replicado desde el antiguo hasta que llega el momento de cambiar el tráfico.
- Desacoplar sistemas: cada consumidor trabaja contra su copia y no contra la fuente.
Replicación frente a ETL
Se confunden porque ambas mueven datos de A a B, pero responden a preguntas distintas:
| Replicación | ETL / ELT | |
|---|---|---|
| Objetivo | Copia equivalente al origen | Dato transformado y modelado |
| Esquema en destino | El mismo del origen | El que pida el análisis |
| Transformación | Ninguna o mínima (tipos, nombres) | Es el núcleo del proceso |
| Quién lo configura | Perfil de sistemas o plataforma | Perfil de datos |
| Qué se rompe al cambiar el origen | La réplica refleja el cambio | El modelo deja de cuadrar |
En la práctica se combinan: primero se replica el origen a una zona en bruto del destino y después se transforma dentro de él. Ese es exactamente el patrón ELT, y la replicación es su primera mitad.
Métodos
1. Copia completa (snapshot)
Cada ejecución reemplaza la tabla destino con todo el contenido del origen.
- ✅ Simple y sin estado que mantener; si una ejecución falla, la siguiente arregla la copia.
- ❌ Coste proporcional al tamaño total, no al número de cambios.
- Encaja con tablas pequeñas o maestros que cambian poco.
2. Incremental por marca de tiempo
Se traen solo las filas modificadas desde la última ejecución. Es la carga incremental clásica.
- ✅ Coste proporcional a los cambios.
- ❌ No detecta borrados físicos: una fila que desaparece del origen se queda para siempre en el destino.
- ❌ Depende de que exista una columna de fecha de modificación fiable.
3. Basada en log de transacciones
Se lee el registro donde la propia base de datos anota cada cambio y se reproduce en el destino. Es la variante que se conoce como CDC.
- ✅ Captura inserciones, modificaciones y borrados.
- ✅ Carga mínima sobre el origen y latencia de segundos.
- ❌ Requiere acceso al log y más piezas en funcionamiento.
Síncrona o asíncrona
- Síncrona: la escritura en el origen no se confirma hasta que la réplica la ha recibido. No se pierde nada, a cambio de que el origen vaya al ritmo del enlace más lento.
- Asíncrona: el origen confirma y la réplica se pone al día después. Es lo normal en analítica, y significa aceptar que la réplica va algo por detrás.
Ese “algo por detrás” tiene nombre operativo: retraso de replicación (lag). Es la métrica que hay que vigilar, porque un enlace de replicación parado no da error: simplemente deja de avanzar y el destino sigue respondiendo consultas con datos de ayer.
Topologías habituales
- Principal → réplica: un único sistema acepta escrituras y las demás copias son de solo lectura. Es la configuración por defecto y la que evita casi todos los problemas.
- Multi-principal: varios sistemas aceptan escrituras y se replican entre sí. Permite escribir en varias regiones, pero obliga a decidir qué pasa cuando dos nodos modifican la misma fila a la vez. Esa resolución de conflictos es la parte difícil, y conviene tener una razón sólida para entrar en ella.
Lo que suele fallar
- Los borrados. Si el método no los captura, el destino acumula filas que ya no existen y nadie lo nota hasta que un recuento no cuadra.
- Los cambios de esquema en el origen. Una columna nueva o un tipo cambiado detiene el enlace o lo deja pasando datos mal.
- La reejecución. Reprocesar la misma ventana de cambios no debe duplicar filas: la escritura tiene que ser idempotente, normalmente con un merge por clave.
- La carga inicial. Antes de replicar en continuo hay que colocar el histórico, y eso es un backfill con sus propias reglas, no el mismo proceso del día a día.
- Replicar porque es fácil. Una copia más es un sistema más que mantener. Si lo que se busca es consultar el dato donde está, la alternativa es la virtualización de datos.
Más información
- Eventos vs batch: los fundamentos de la integración de datos — capítulo de la guía práctica de arquitectura de datos de Dataprix.
- Compara herramientas de integración de datos en el directorio de Dataprix.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.