Carga incremental: qué es y cómo cargar solo lo que ha cambiado
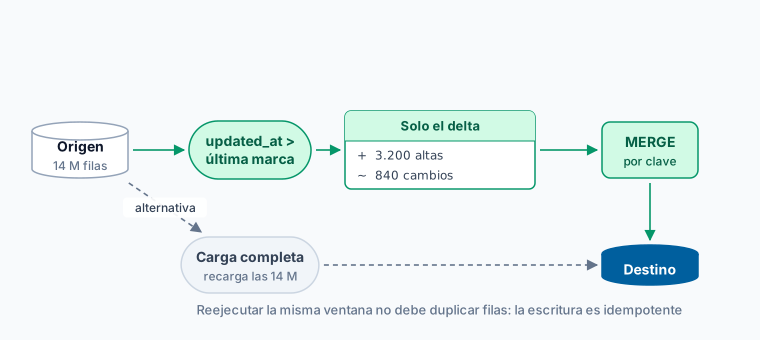
Carga incremental
¿Qué es?
La carga incremental es la estrategia de procesar en cada ejecución solo los datos nuevos o modificados desde la ejecución anterior, en lugar de volver a leer y reescribir la tabla entera.
Su alternativa es la carga completa (full refresh): borrar el destino y reconstruirlo desde cero cada vez. La carga completa es más simple y más fácil de razonar; la incremental es la que hace viable un pipeline cuando la tabla crece.
¿Para qué sirve?
- Reducir tiempo de proceso: una tabla de cientos de millones de filas que recibe miles de altas al día no necesita reprocesarse completa.
- Reducir coste: en un almacén que factura por cómputo escaneado, la diferencia entre leer la tabla y leer la última partición es directamente la factura.
- Bajar la latencia: ciclos más cortos permiten ejecutar cada hora en vez de cada noche, y con ello mejorar la frescura de datos de la tabla destino.
- Liberar la ventana nocturna: deja de ser un cuello de botella cuando los procesos dejan de crecer con el histórico.
Cómo se detecta lo que ha cambiado
1. Marca de tiempo (high-water mark)
Se guarda el valor máximo de una columna de fecha (updated_at, fecha_modificacion) de la última ejecución y se piden solo las filas posteriores.
- ✅ Sencillo, no necesita permisos especiales en el origen.
- ❌ Exige que el origen actualice esa columna siempre, también en los updates hechos por scripts o migraciones.
- ❌ No detecta borrados, salvo que el origen use baja lógica.
- ❌ Las filas que llegan con la marca ya pasada (procesos que escriben en diferido) se pierden si la ventana es estricta.
2. Secuencia o identificador creciente
Mismo mecanismo con un id autoincremental o un número de versión.
- ✅ Inmune a los problemas de reloj y de zona horaria.
- ❌ Solo sirve para altas: una fila modificada conserva su
id.
3. Lectura del log de transacciones
Es lo que hace el CDC: leer el registro de cambios del motor de base de datos y emitir cada insert, update y delete como un evento.
- ✅ Captura también los borrados y no depende de la disciplina del origen.
- ✅ Carga mínima sobre la base operativa.
- ❌ Requiere acceso al log y más piezas en el pipeline.
4. Comparación por huella
Se calcula un hash de cada fila y se comparan las huellas con el destino.
- ✅ Funciona cuando el origen no ofrece ninguna señal de cambio.
- ❌ Hay que leer el origen completo, así que ahorra escrituras pero no lecturas.
El patrón de escritura: merge
Detectar el cambio es la mitad; la otra es escribirlo sin duplicar. La operación habitual es un merge (o upsert) sobre una clave de negocio: si la fila existe se actualiza, y si no, se inserta. Es lo que generan las materializaciones incrementales de dbt y lo que ofrecen de serie los formatos de tabla de un data lakehouse.
Si lo que interesa es conservar el valor anterior en vez de sobrescribirlo —el precio que tenía un producto cuando se vendió, no el de hoy—, el merge no basta: eso es una dimensión de cambio lento.
Por qué tiene que ser idempotente
Un proceso incremental se reejecuta constantemente: fallos de red, reintentos del orquestador, una ejecución manual para tapar un hueco. Si volver a procesar la misma ventana duplica filas, el pipeline produce cifras distintas según cuántas veces haya fallado.
La propiedad que lo evita es la idempotencia: la ejecución se define por la ventana que procesa, no por el momento en que corre, y escribe reemplazando esa ventana. Combinado con particionado por fecha, la forma más robusta es sustituir la partición completa del día en lugar de añadir filas a ciegas.
Riesgos que conviene conocer
- Deriva silenciosa. Si una fila se modifica sin actualizar su marca de tiempo, el destino queda desfasado y nada avisa. El remedio práctico es una recarga completa periódica, más espaciada, que reconcilie.
- Borrados invisibles. Con marca de tiempo, lo que desaparece del origen se queda en el destino para siempre.
- El hueco del primer día. Toda tabla incremental necesita una carga inicial del histórico: eso es un backfill, y conviene escribirlo como parte del pipeline y no como un script suelto, porque se vuelve a necesitar cada vez que cambia la lógica.
- Ventanas demasiado justas. Procesar exactamente desde la última marca deja fuera lo que llegó con retraso. Un solape deliberado de unas horas cuesta poco si la escritura es idempotente.
Cuándo no merece la pena
Si la tabla cabe en una recarga completa dentro de la ventana disponible, la carga completa gana: no acumula deriva, no necesita reconciliación y cualquiera entiende lo que hace. La complejidad incremental se paga en mantenimiento durante toda la vida del pipeline de datos, así que conviene introducirla cuando el volumen la justifica, no por anticipado.
Más información
- Eventos vs batch: los fundamentos de la integración de datos — capítulo de la guía práctica de arquitectura de datos de Dataprix.
- Compara herramientas de integración de datos en el directorio de Dataprix.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.