dbt (data build tool): qué es y por qué es estándar en data engineering
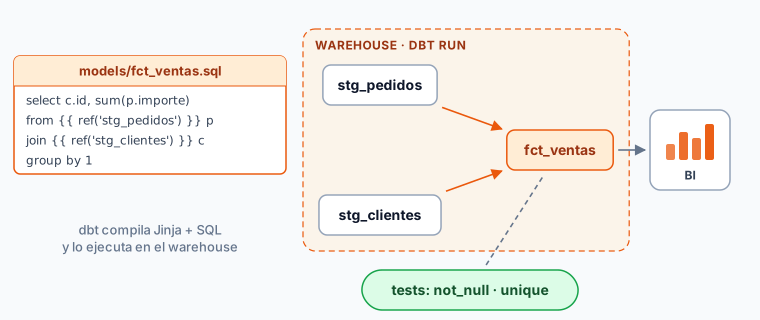
dbt (data build tool)
¿Qué es?
dbt (data build tool) es la herramienta open-source que se ha convertido en estándar de facto para la capa de transformación en stacks ELT modernos. Permite escribir transformaciones de datos como código SQL versionado en git, con tests, documentación y dependencias gestionadas.
Existe en dos sabores:
- dbt Core (open source, gratuito): el motor que ejecuta las transformaciones.
- dbt Cloud (SaaS de pago): UI web, scheduler, IDE en el navegador, observabilidad.
Por qué cambió la forma de hacer data engineering
Antes de dbt, las transformaciones SQL vivían como queries dispersas en herramientas BI, vistas creadas a mano en el DW, o dentro de un ETL gráfico difícil de versionar. dbt aportó al data engineering las prácticas del software engineering:
- Código versionado en git (PRs, code review, rollbacks).
- Tests automáticos sobre los datos (
unique,not_null, custom). - Documentación generada desde el propio código.
- DAG implícito: dbt detecta dependencias entre modelos por las referencias
ref()y los ejecuta en orden. - Reusabilidad: macros y paquetes (dbt-utils, dbt-expectations).
Cómo funciona
Un modelo dbt es un fichero SQL del tipo:
-- models/marts/dim_customer.sql
SELECT
    customer_id,
    first_name,
    last_name,
    DATE(created_at) AS signup_date
FROM {{ ref('stg_crm_customers') }}
WHERE deleted_at IS NULL
Al ejecutar dbt run, dbt:
- Compila el SQL sustituyendo
ref()por el nombre real de la tabla/vista. - Resuelve las dependencias entre modelos.
- Crea/actualiza la tabla o vista correspondiente en el data warehouse.
Ejemplo de proyecto típico
mi_proyecto_dbt/
├─ models/
│  ├─ staging/      # 1:1 con las fuentes (E+L de Fivetran/Airbyte)
│  ├─ intermediate/ # joins y reglas comunes
│  └─ marts/        # tablas finales para BI (dim_*, fact_*)
├─ tests/           # tests genéricos y custom
├─ macros/          # SQL reutilizable
└─ dbt_project.yml
Cuándo dbt es la elección obvia
- Stack moderno con DW cloud (Snowflake, BigQuery, Redshift, Databricks).
- Equipo que mezcla analistas con conocimientos SQL y data engineers.
- Necesidad de modelo dimensional limpio sobre datos crudos cargados con ELT.
Cuándo NO es la mejor opción
- Stack 100% on-prem con DW legacy (puede usarse, pero pierde parte del valor).
- Transformaciones que requieren lógica imperativa compleja (Python, ML): combinar dbt con Airflow/Dagster.
- Pipelines de streaming de baja latencia: dbt es batch.
Más información
- Airflow, Prefect, dbt, NiFi y Kafka: comparativa práctica — capítulo de la guía práctica de arquitectura de datos de Dataprix.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.