Ingesta de datos: qué es y los dos patrones para traerlos a un sistema
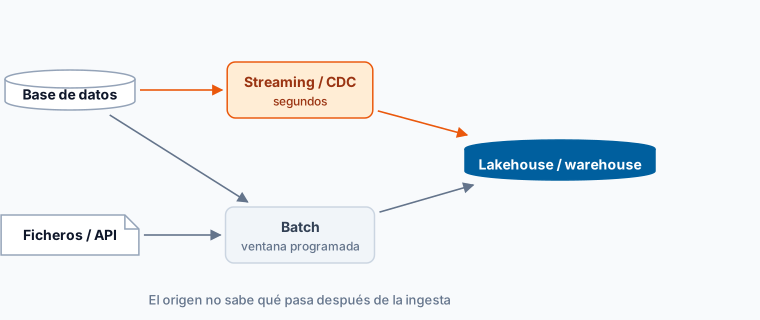
Ingesta de datos
¿Qué es?
La ingesta de datos es el proceso de traer datos desde un sistema origen (una base de datos operativa, una API, un fichero, un sensor) hasta la plataforma donde se van a analizar o procesar. Es el primer eslabón de cualquier pipeline: antes de transformar, limpiar o modelar nada, los datos tienen que haber entrado.
¿Para qué sirve?
Separar la ingesta del resto del pipeline tiene una ventaja concreta: permite que el sistema origen no se entere de lo que pasa después. Un ERP solo necesita saber que alguien lee sus tablas o su log de cambios; no le importa si el destino es un data lake, un data lakehouse o tres sistemas distintos a la vez.
Los dos patrones
Ingesta por lotes (batch)
Se extrae un conjunto de datos de golpe, en una ventana programada (cada hora, cada noche). Es el patrón clásico de un proceso ETL o ELT: simple de construir y de depurar, con un coste que crece poco con el volumen. A cambio, los datos del destino siempre tienen la antigüedad de la última ejecución.
Ingesta en streaming
Los datos llegan como un flujo continuo de eventos, normalmente a través de un bus de mensajes como Apache Kafka. El caso más habitual en sistemas con una base de datos operativa detrás es CDC: capturar cada cambio del origen y propagarlo en segundos, sin esperar a una ventana de proceso. Es más complejo de operar, pero necesario cuando el dato tiene que llegar casi en el instante en que ocurre.
Entre ambos extremos está la carga incremental: sigue siendo batch, pero en vez de releer todo el origen cada vez, trae solo lo que ha cambiado desde la última ejecución.
Ejemplo
Una empresa de distribución ingesta datos de tres formas distintas hacia el mismo lakehouse:
- El catálogo de productos, que cambia poco, se trae cada noche por lotes desde el ERP.
- El stock, que hay que ver casi al segundo, llega por CDC desde la base del ERP vía Kafka.
- Los eventos de la web (clics, búsquedas) llegan en streaming directamente desde el frontend.
Las tres rutas de ingesta aterrizan en la misma capa bruta del lakehouse, y desde ahí el resto del pipeline ya no necesita saber de dónde vino cada dato ni cómo llegó.
Qué no es
La ingesta trae los datos; no los limpia, no los modela ni decide qué forma final tendrán. Esa parte —transformar lo ingerido en algo consultable— es el trabajo que hacen ETL, ELT o un modelo dbt a partir de los datos ya ingeridos, no la ingesta en sí.
Más información
Compara herramientas de integración de datos en el directorio de Dataprix.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.