Data virtualization: qué es y en qué se diferencia de un ETL
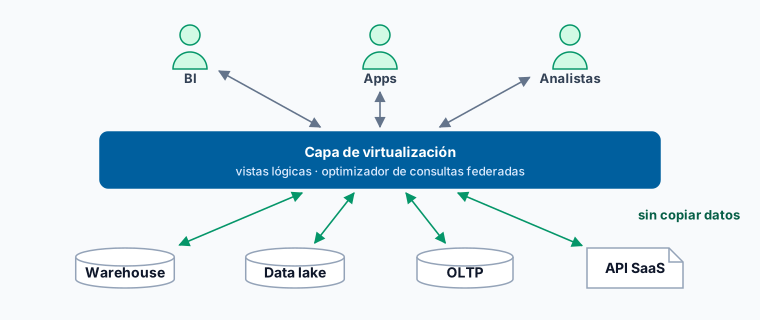
Data virtualization (virtualización de datos)
¿Qué es?
La virtualización de datos es una técnica de integración que crea una capa lógica unificada sobre fuentes de datos dispersas —bases de datos, data warehouses, APIs, ficheros— sin moverlas ni copiarlas físicamente. El consumidor consulta una vista única, y el motor de virtualización traduce esa consulta a las fuentes reales en tiempo real y combina los resultados.
Es el enfoque opuesto a la integración tradicional por replicación: en lugar de copiar los datos a un almacén central, se dejan donde están y se accede a ellos bajo demanda.
Cómo funciona
- Se conectan las fuentes a la capa de virtualización (conectores).
- Se definen vistas lógicas que unen y transforman los datos de varias fuentes.
- Cuando alguien consulta una vista, el motor genera consultas federadas, las envía a cada fuente, combina los resultados y los devuelve.
- Opcionalmente se cachean resultados para mejorar el rendimiento.
Data virtualization vs ETL
| Data virtualization | ETL | |
|---|---|---|
| Movimiento de datos | No copia (acceso en vivo) | Copia a un destino |
| Latencia del dato | Tiempo real | Según la frecuencia de carga |
| Almacenamiento extra | Mínimo | Duplicación en el DW |
| Carga sobre las fuentes | Alta (consultas en vivo) | Baja (cargas programadas) |
| Mejor para | Vistas ágiles, prototipos, datos volátiles | Volumen alto, histórico, transformación pesada |
No son excluyentes: muchas arquitecturas usan ETL para el histórico y virtualización para combinarlo con datos operativos recientes.
Ventajas y límites
Ventajas: rapidez de implantación, datos siempre frescos, menos duplicación, capa de gobierno centralizada.
Límites: el rendimiento depende de las fuentes (una consulta pesada puede saturar un sistema operativo); no sustituye a un data warehouse cuando hace falta histórico, transformación compleja o cargas analíticas masivas.
Para qué sirve
- Crear una vista 360° del cliente combinando CRM, ERP y soporte sin un proyecto de DW.
- Prototipar integraciones antes de decidir qué consolidar físicamente.
- Alimentar una data fabric o una capa semántica con acceso unificado.
Más información
- ETL — el enfoque por replicación con el que se compara
- Data fabric — arquitectura que apoya en la virtualización
- Capa semántica — consume la vista unificada para el negocio
Para ver herramientas de integración de datos del mercado, consulta el directorio de integración de datos de Dataprix.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.