Apache Flink: qué es y para qué se usa
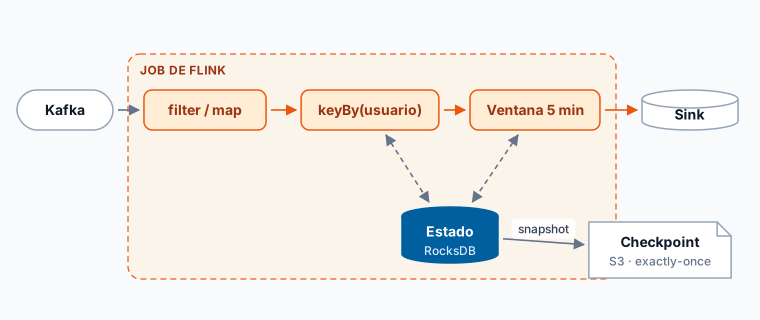
Apache Flink es un motor de procesamiento distribuido para flujos de datos continuos. Su planteamiento de partida lo diferencia del resto: en Flink el flujo es el caso general y un proceso por lotes no es más que un flujo con principio y final conocidos. Otros motores hacen lo contrario, tratar el flujo como una sucesión de lotes muy pequeños.
Qué lo distingue
- Procesa evento a evento, no en microlotes. Eso permite latencias muy bajas sin esperar a que se cierre una ventana de tiempo.
- Gestiona estado de forma nativa y con tolerancia a fallos. Un trabajo puede recordar agregados, contadores o el último valor visto por clave, y recuperarse desde un punto de control sin perderlo.
- Distingue el tiempo del evento del tiempo de proceso. Un dato que llega tarde por un problema de red se puede seguir imputando al momento en que ocurrió realmente, no a cuando llegó. Es la diferencia entre un informe correcto y uno que cuadra por casualidad.
Para qué se usa
Los casos donde encaja tienen un patrón común: la respuesta pierde valor si llega tarde.
- Detección de fraude o de anomalías mientras la operación está en curso.
- Enriquecimiento de eventos en tránsito, uniendo un flujo con datos de referencia.
- Métricas operativas continuas sobre ventanas móviles.
- Materialización de cambios capturados con CDC desde bases de datos operativas hacia el almacén analítico.
Habitualmente lee de un bus de eventos como Apache Kafka y escribe en un destino analítico o en otro topic. Kafka transporta y retiene; Flink calcula.
Cuándo no hace falta
El procesamiento de flujos añade complejidad operativa real: gestión de estado, puntos de control, reprocesos. Si el negocio consume la información una vez al día, un pipeline por lotes es más simple, más barato y más fácil de depurar.
La pregunta útil no es si los datos llegan continuamente, sino cada cuánto se toma una decisión con ellos. Si nadie mira el dato hasta mañana, calcularlo al instante no aporta nada.
En el directorio de Dataprix encontrarás el análisis y la comparativa de las herramientas de integración y procesamiento de datos del mercado.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.