Reverse ETL: qué es, para qué sirve y ejemplo práctico
Reverse ETL
¿Qué es?
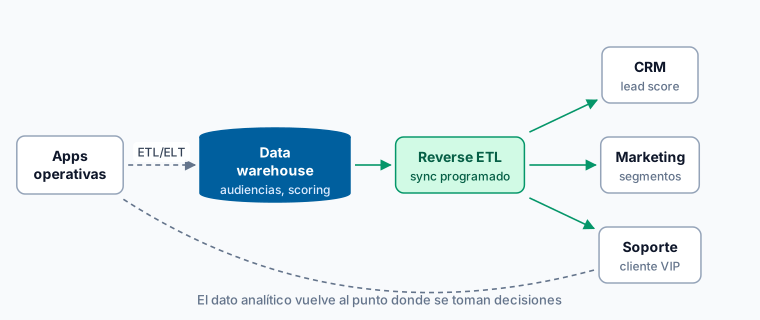
Reverse ETL (a veces data activation u operational analytics) es el proceso de mover datos modelados desde el data warehouse hacia aplicaciones operacionales (CRM, plataformas de marketing, herramientas de soporte, sistemas de facturación, pasarelas de pago).
El nombre invierte conceptualmente al ETL clásico: en lugar de extraer de fuentes operacionales y cargar en analítica, la dirección es la opuesta — extraer de analítica y cargar en operacional.
Por qué surgió
El stack moderno de datos llevó toda la información a un único warehouse (Snowflake, BigQuery, Databricks, Redshift) y la transformó en modelos canónicos vía dbt. Pero esa riqueza se quedaba ahí: el equipo de ventas seguía sin ver el LTV del cliente en Salesforce, el de marketing no podía segmentar audiencias en Braze con los scores calculados en el warehouse, el de soporte respondía a tickets sin conocer la salud de la cuenta.
Reverse ETL cierra ese bucle: los modelos que ya viven en el warehouse — entidad cliente unificada, predicciones de churn, scoring de leads — se sincronizan periódicamente con las herramientas donde los equipos operativos toman decisiones.
Cómo funciona
Una herramienta de reverse ETL típicamente:
- Se conecta al warehouse (Snowflake, BigQuery, Databricks, Postgres).
- Lee el resultado de un modelo o una query SQL definida por el usuario.
- Mapea las columnas del resultado a campos del destino (Salesforce, HubSpot, Iterable, Braze, Marketo, Zendesk, etc.).
- Sincroniza los registros por upsert (insertar nuevos, actualizar existentes) con la cadencia configurada — desde casi tiempo real hasta una vez al día.
- Gestiona errores, logs, deltas (solo enviar lo que ha cambiado) y rate limits del destino.
A diferencia del ELT clásico, el destino es habitualmente una API SaaS con sus propias limitaciones (rate limits, validaciones, idempotencia), no un destino analítico permisivo.
Ejemplo
Una empresa B2B SaaS con stack moderno usa reverse ETL para activar predicciones del warehouse:
- En el warehouse existe el modelo
marts.scoring_churn_clientes, alimentado por dbt con datos de uso, soporte y facturación, y enriquecido por un modelo ML. - El equipo de Customer Success trabaja en Salesforce. Necesita ver el
churn_scoreactualizado de cada cuenta para priorizar llamadas proactivas. - Una herramienta de reverse ETL (Hightouch, Census o similar) conecta
marts.scoring_churn_clientescon el campo personalizadoChurn_Risk_Score__cen la entidad Account de Salesforce. - Cadencia: sincronización cada 4 horas. La herramienta detecta qué
account_idhan cambiado de score y solo envía esos a la API. - Resultado: el equipo de Customer Success ve scores frescos en su entorno habitual y puede crear vistas, alertas y reglas de asignación basadas en datos que antes solo existían en el warehouse.
Diferencia con ETL/ELT clásico
| ETL clásico | ELT moderno | Reverse ETL | |
|---|---|---|---|
| Origen | Sistemas operacionales | Sistemas operacionales | Data warehouse |
| Destino | Data warehouse | Data warehouse | Sistemas operacionales (SaaS, APIs) |
| Transformación | En vuelo | En el warehouse (dbt) | Definida por SQL en el warehouse |
| Propósito | Análisis y reporting | Análisis y reporting | Activación operativa |
| Latencia típica | Horas / días | Minutos / horas | Minutos / horas |
ETL y reverse ETL son complementarios, no excluyentes. La mayoría de organizaciones modernas usan los tres.
Cuándo NO usar reverse ETL
- Datos en tiempo real estricto: si el caso de uso exige latencias por debajo del minuto (fraud detection operativa, personalización web en vivo), la arquitectura correcta es streaming (Kafka, Flink) o un Real-Time Context Engine, no batch sync periódico.
- Sistema de origen único: si solo necesitas sincronizar dos SaaS entre sí sin pasar por el warehouse, una herramienta de iPaaS clásica (Workato, Zapier, Make) es más directa.
- Volúmenes masivos sin SLA: el coste por registro sincronizado en herramientas reverse ETL puede ser alto. Para sincronizaciones de millones de filas cada hora, conviene evaluar APIs directas o exports/imports nativos.
Tecnologías de referencia
- Standalone: Hightouch, Census, Polytomic, Grouparoo (open source).
- Integradas en plataforma: Snowflake (con sync nativos en preview), dbt Cloud (Operational Analytics), HubSpot Operations Hub.
- Open source: Polytomic Lite, RudderStack Reverse ETL.
Más información
- ETL — el proceso clásico al que reverse ETL le da la vuelta
- ELT — el patrón moderno que prepara los datos en el warehouse
- dbt — la herramienta que normalmente genera los modelos que luego se activan
- ETL vs ELT: cuándo transformar en el origen o en el destino — capítulo de la guía práctica de arquitectura de datos de Dataprix.
- Compara plataformas en el directorio de integración de Dataprix.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.