Vector database: qué es y por qué es clave en IA generativa
Vector database
¿Qué es?
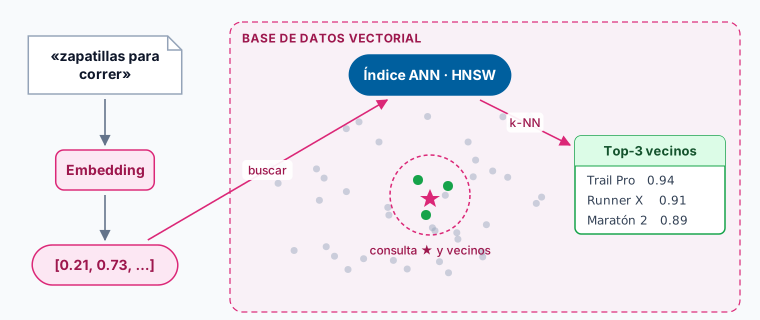
Una base de datos vectorial (o vector database) es un sistema de almacenamiento optimizado para guardar y consultar vectores numéricos de alta dimensión —llamados embeddings— usando búsquedas de similitud, típicamente con algoritmos como HNSW (Hierarchical Navigable Small World) o IVF (Inverted File Index).
¿Para qué sirve?
En el contexto de IA generativa, las bases vectoriales son la pieza central de las arquitecturas RAG (Retrieval Augmented Generation): permiten encontrar fragmentos de texto semánticamente similares a una consulta para inyectarlos como contexto en un Large Language Model (LLM).
También se usan para sistemas de recomendación, búsqueda semántica de imágenes, detección de duplicados y clasificación basada en similitud.
Ejemplo
Un asistente de soporte al cliente que responde preguntas sobre la documentación interna:
- Toda la documentación se trocea en fragmentos y se convierte en vectores con un modelo de embeddings.
- Los vectores se almacenan en una base vectorial (Pinecone, Weaviate, Qdrant, pgvector…).
- Cuando un usuario pregunta, su consulta se vectoriza y se buscan los fragmentos más similares.
- Esos fragmentos se inyectan en el prompt del LLM como contexto, y el modelo responde basándose en la documentación recuperada.
Tecnologías de referencia
- Pinecone, Weaviate, Qdrant, Milvus: bases vectoriales especializadas.
- pgvector: extensión de PostgreSQL que añade tipo vector y operadores de similitud.
- Chroma: ligero, popular en prototipos y desarrollo local.
- Elasticsearch / OpenSearch con kNN search: opción si ya tienes el stack desplegado.
Más información
Lee artículos sobre arquitecturas RAG y stack de IA empresarial en Dataprix.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.