Embeddings: qué son y por qué importan en IA y búsqueda semántica
Embeddings
¿Qué es?
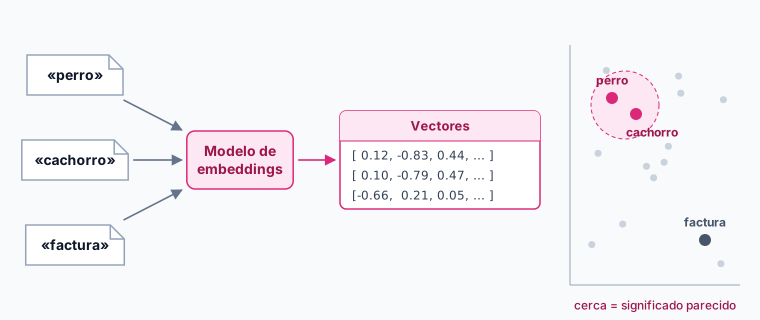
Un embedding es una representación numérica de un dato —una palabra, una frase, un documento, una imagen o incluso un producto— en forma de vector: una lista de números (por ejemplo, 768 o 1.536 dimensiones). La clave es que ese vector no es arbitrario: se construye de manera que datos con significado parecido quedan cerca en el espacio vectorial y datos distintos quedan lejos. Los embeddings son la forma en que los sistemas de IA “entienden” la semántica de la información en lugar de tratarla como texto literal.
Cómo funcionan
Los embeddings se generan con modelos entrenados (redes neuronales) que han aprendido a proyectar entradas a un espacio donde la distancia refleja la similitud. Por ejemplo, en un buen modelo de texto:
- Los vectores de “perro” y “cachorro” estarán próximos.
- “perro” y “lavadora” estarán lejos.
- Operaciones aritméticas tienen sentido semántico: el clásico rey − hombre + mujer ≈ reina.
Para comparar dos embeddings se usa una medida de distancia, normalmente la similitud del coseno o la distancia euclídea. Cuanto menor es la distancia, más relacionados están los elementos. Modelos populares para generar embeddings incluyen las familias de OpenAI, Cohere, los modelos open source de Sentence Transformers y los embeddings multimodales que mezclan texto e imagen.
Para qué sirven
Los embeddings son la pieza que conecta datos no estructurados con la IA moderna:
- Búsqueda semántica: encontrar resultados por significado, no por coincidencia exacta de palabras. Buscar “coche barato” devuelve también “vehículo económico”.
- RAG (Retrieval-Augmented Generation): recuperar los fragmentos de documentación más relevantes para dárselos a un LLM como contexto.
- Sistemas de recomendación: productos, artículos o canciones “parecidos” se localizan por proximidad de sus vectores.
- Clasificación y clustering: agrupar documentos o detectar duplicados y anomalías.
- Deduplicación y matching de entidades: identificar que “Telefónica S.A.” y “Telefonica SA” son la misma empresa.
Embeddings y bases de datos vectoriales
Generar embeddings es solo la mitad del trabajo: hay que almacenarlos y buscarlos eficientemente. Para eso existen las bases de datos vectoriales, que indexan millones de vectores y resuelven la consulta “dame los 10 más parecidos a este” en milisegundos mediante algoritmos de vecinos más cercanos aproximados (ANN). Embeddings + base de datos vectorial + LLM es la arquitectura base de la mayoría de aplicaciones de IA empresarial actuales.
Limitaciones y consideraciones
- Dependen del modelo: dos embeddings solo son comparables si los generó el mismo modelo (o uno compatible). Cambiar de modelo obliga a regenerar todo el índice.
- Coste de regeneración: actualizar el modelo de embeddings implica reprocesar todo el corpus.
- Sesgo heredado: si el modelo de entrenamiento tenía sesgos, los embeddings los reproducen.
- Dimensión vs coste: más dimensiones capturan más matiz pero encarecen almacenamiento y búsqueda.
Más información
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.