RAG (Retrieval Augmented Generation): qué es y cómo funciona
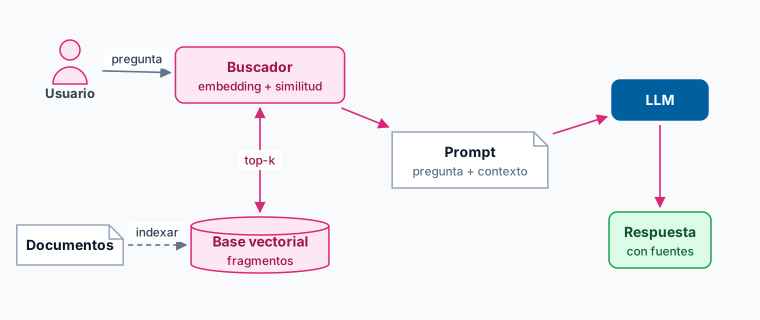
RAG (Retrieval Augmented Generation)
¿Qué es?
RAG (Retrieval Augmented Generation, generación aumentada por recuperación) es un patrón arquitectónico para usar Large Language Models (LLMs) sobre datos propios de la organización, sin necesidad de reentrenar ni hacer fine-tuning del modelo.
La idea fundamental: en vez de pedir al LLM que sepa todo de memoria, le buscamos los fragmentos relevantes en una base de conocimiento y se los pasamos como contexto en el prompt. El LLM responde basándose en esos fragmentos, no en su conocimiento general.
Por qué se usa tanto
Los LLMs tienen limitaciones intrínsecas:
- Cutoff de entrenamiento: no conocen información posterior a su fecha de corte.
- Hallucinations: inventan respuestas plausibles cuando no saben.
- Datos propios: no conocen tu documentación interna, tus contratos, tus tickets.
RAG mitiga las tres con un coste mucho menor que reentrenar:
- Datos actualizables: añades un documento al índice y al instante el LLM puede responder sobre él.
- Trazabilidad: el sistema puede citar las fuentes concretas de cada respuesta.
- Reducción de hallucinations: el contexto explícito ancla las respuestas a hechos verificables.
- Sin reentrenamiento: el modelo base no se toca.
Cómo funciona — arquitectura típica
Fase 1: Indexación (offline)
- Trocear los documentos en fragmentos manejables (chunks de 200-1000 tokens).
- Generar embeddings de cada fragmento con un modelo de embeddings (text-embedding-3, e5-large, BGE).
- Almacenar los vectores y el texto original en una base vectorial (Pinecone, Weaviate, Qdrant, pgvector, Chroma).
Fase 2: Consulta (online)
- El usuario hace una pregunta.
- Vectorizar la pregunta con el mismo modelo de embeddings.
- Buscar los k fragmentos más similares en la base vectorial (kNN, típicamente con HNSW).
- Componer prompt con la pregunta + los fragmentos recuperados.
- Llamar al LLM (GPT-4o, Claude, Gemini, Llama).
- Devolver la respuesta + las fuentes citadas.
Ejemplo
Asistente de soporte interno sobre la documentación corporativa:
- Indexación: 3.000 páginas de wiki + 8.000 tickets resueltos del histórico → troceados, embebidos, en Qdrant.
- Pregunta de un empleado: “¿Cómo activo el SSO con Azure AD?”
- Retrieval: encuentra 5 chunks: la guía de configuración del wiki, dos tickets resueltos sobre el mismo tema, un email del equipo IT con un detalle de versión.
- Generación: el LLM compone una respuesta clara y cita los 5 documentos.
- Resultado: el empleado obtiene en 3 segundos una respuesta que antes le costaba 30 minutos de búsqueda + esperar al equipo IT.
Variantes y mejoras
- Hybrid search: combinar búsqueda semántica (vectores) con búsqueda lexical (BM25, Elasticsearch). Captura tanto similitud conceptual como matches exactos.
- Reranking: tras recuperar 50 fragmentos, un reranker (Cohere Rerank, BGE-reranker) los reordena por relevancia real.
- Multi-hop: el sistema hace varias rondas de retrieval+generación para preguntas complejas.
- Agentic RAG: el LLM decide autónomamente qué herramientas usar (RAG, búsqueda web, APIs).
- GraphRAG: combinar RAG con grafos de conocimiento.
Limitaciones reales de RAG
- Calidad de chunks: chunks mal hechos arruinan todo. El troceado es ingeniería seria.
- Información dispersa: si la respuesta requiere combinar 20 fuentes, RAG se queda corto.
- Datos estructurados: para tablas y bases de datos, “Text-to-SQL” suele funcionar mejor.
- Coste por consulta: cada pregunta tira al menos un embedding + una llamada al LLM.
Tecnologías de referencia
- Frameworks: LangChain, LlamaIndex, Haystack.
- Bases vectoriales: Pinecone, Weaviate, Qdrant, Milvus, pgvector, Chroma.
- Embeddings: OpenAI text-embedding-3, Cohere, BGE, e5.
- Plataformas integradas: Azure AI Search, AWS Bedrock Knowledge Bases, Vertex AI Search.
Más información
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.