MLOps: qué es y por qué los modelos en producción necesitan disciplina
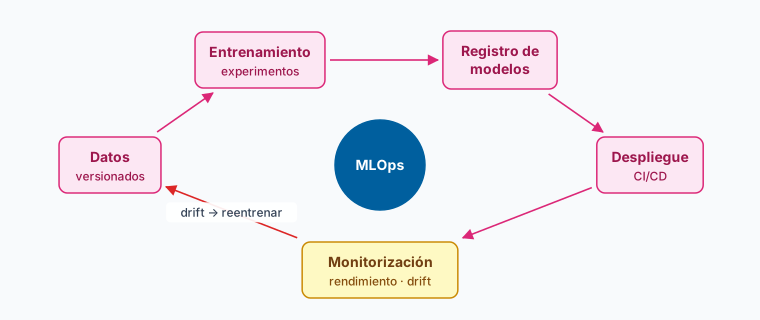
MLOps
¿Qué es?
MLOps (Machine Learning Operations) es la disciplina que aplica las prácticas de DevOps al ciclo de vida completo de los modelos de Machine Learning: experimentación, entrenamiento, validación, despliegue, monitorización en producción y reentrenamiento controlado.
Surge para resolver un problema persistente: la mayoría de los modelos entrenados por equipos de data science nunca llegan a producción, o llegan y se degradan silenciosamente porque nadie los está vigilando.
Por qué hace falta una disciplina nueva
Un modelo de ML no es como una aplicación tradicional. Tiene tres ejes que cambian de forma independiente:
- Código (el algoritmo, la lógica del pipeline).
- Datos (el dataset cambia constantemente).
- Modelo entrenado (los pesos resultantes del entrenamiento).
DevOps clásico solo gestiona el primer eje. MLOps gestiona los tres y sus interacciones.
Las prácticas core de MLOps
1. Versionado completo
- Código: git, como siempre.
- Datos: DVC, LakeFS, datasets etiquetados en data warehouse.
- Modelos: MLflow, Weights & Biases, registro de modelos.
Imprescindible para reproducir resultados y rebobinar cuando algo falla.
2. Pipelines de entrenamiento como código
El entrenamiento se ejecuta como un pipeline reproducible (Kubeflow, Airflow, Metaflow, Prefect), no en notebooks dispersos.
3. Despliegue controlado
- Batch: el modelo se aplica periódicamente sobre tablas (predicción de churn cada noche).
- Real-time: API que responde a cada petición (recomendaciones, scoring).
- Streaming: modelo dentro de un pipeline Kafka/Flink.
Patrones de release: shadow deployment, canary, A/B testing.
4. Monitorización en producción
- Métricas técnicas: latencia, throughput, errores. (Como cualquier servicio).
- Métricas de modelo: precisión, recall, AUC sobre etiquetas reales (cuando llegan).
- Detección de drift: cambios en la distribución de features (data drift) o en la relación con el target (concept drift).
- Equidad y sesgo: monitorizar que el modelo no degrade para subgrupos concretos.
5. Reentrenamiento controlado
Decidir cuándo reentrenar (calendario, drift detectado, degradación de métrica) y hacerlo de forma reproducible, validada y revisada.
Tecnologías de referencia
Plataformas integrales:
- MLflow — de facto en open source, gestión de experimentos y registro de modelos.
- Kubeflow — pipelines ML sobre Kubernetes.
- Vertex AI (Google), SageMaker (AWS), Azure ML — managed end-to-end.
- Databricks ML — sobre el lakehouse.
Específicas:
- Versionado de datos: DVC, LakeFS.
- Feature stores: Feast, Tecton.
- Servicio de modelos: BentoML, KServe, Triton.
- Monitorización: Evidently, WhyLabs, Arize.
Niveles de madurez (Google)
Google publicó una clasificación útil:
- Nivel 0: pipelines manuales, modelos como ficheros sueltos.
- Nivel 1: pipelines automatizados de entrenamiento, despliegue automatizado.
- Nivel 2: CI/CD completo para modelos + monitorización avanzada + reentrenamiento automático.
La mayoría de empresas que dicen “hacemos ML” están en nivel 0 o 1. Llegar al nivel 2 es lo que permite operar decenas de modelos en producción sin que sea un infierno.
¿Y la IA generativa?
LLMs y modelos generativos requieren prácticas específicas que algunos llaman LLMOps: gestión de prompts, eval de outputs, monitorización de coste por token, versionado de embeddings, evaluación de hallucinations. Es MLOps con vocabulario adaptado.
Más información
Compara plataformas de IA y datos en el directorio de Dataprix.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.