DataOps: qué es y qué prácticas incluye
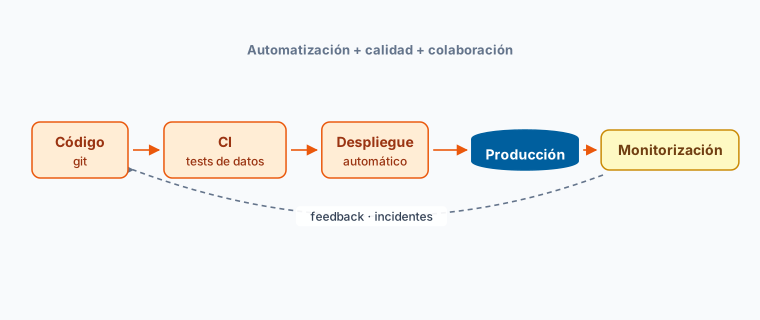
DataOps
¿Qué es?
DataOps es un conjunto de prácticas que aplica al trabajo con datos lo que DevOps trajo al desarrollo de software: automatizar, probar y desplegar de forma continua y controlada. En lugar de tratar los pipelines de datos como scripts artesanales que alguien ejecuta y vigila a mano, los trata como código que se versiona, se valida automáticamente y se despliega con un proceso repetible.
No es una herramienta ni un producto: es una forma de organizar el trabajo, apoyada en herramientas que ya existen.
Qué problema resuelve
El escenario típico sin DataOps es reconocible: transformaciones repartidas entre scripts sueltos y consultas guardadas en el portátil de alguien, nadie sabe con seguridad qué versión está en producción, un cambio en una tabla de origen rompe tres informes sin previo aviso, y el error se descubre cuando lo detecta el destinatario del informe.
DataOps ataca ese patrón: hace que los fallos se detecten antes de llegar a quien consume el dato, y que un cambio se pueda revisar y revertir.
Prácticas que incluye
- Control de versiones de todo: transformaciones, definiciones de modelos y configuración viven en un repositorio, con historial y revisión de cambios.
- Pruebas automáticas sobre los datos: además de probar el código, se comprueba el propio dato —que no haya nulos donde no debe, que las claves sean únicas, que los totales estén dentro de rango— y el pipeline se detiene si falla.
- Integración y despliegue continuos: los cambios pasan por un entorno de pruebas y se promocionan a producción de forma automatizada, no copiando ficheros a mano.
- Orquestación: las dependencias entre tareas se declaran explícitamente y se ejecutan en orden, con reintentos y alertas.
- Monitorización y observabilidad: se vigila la frescura, el volumen y la forma de los datos, no solo si el proceso terminó sin error.
- Colaboración entre roles: ingeniería, analítica y negocio trabajan sobre las mismas definiciones en lugar de mantener versiones paralelas de la misma métrica.
Para qué sirve
- Menos incidencias silenciosas: los problemas de calidad se detectan en el pipeline, no en el cuadro de mando.
- Cambios más rápidos y menos arriesgados: se puede modificar una transformación sabiendo que las pruebas avisarán si algo se rompe.
- Trazabilidad: queda registrado quién cambió qué y cuándo, lo que facilita auditar y volver atrás.
- Menos dependencia de personas concretas: el conocimiento está en el repositorio, no en la cabeza de quien construyó el proceso.
DataOps, DevOps y MLOps
Los tres comparten filosofía y se diferencian por el objeto sobre el que trabajan: DevOps automatiza el ciclo de vida del software, DataOps el de los datos y sus transformaciones, y MLOps el de los modelos de machine learning. En una organización que hace analítica avanzada suelen convivir, y MLOps se apoya en buena medida sobre lo que DataOps haya dejado montado.
Más información
- Data pipeline — el proceso que DataOps automatiza y vigila
- Calidad de datos — lo que las pruebas automáticas defienden
- Data observability — la vigilancia continua del estado de los datos
- MLOps — el equivalente para modelos de machine learning
- dbt — herramienta que popularizó las pruebas y el versionado en transformaciones
- Data contract — el acuerdo explícito que evita roturas entre productor y consumidor
Para comparar las herramientas sobre las que se apoyan estas prácticas, el directorio de integración de datos de Dataprix reúne fichas y análisis editorial de las principales plataformas.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.