Sharding: qué es y cómo particiona una base de datos
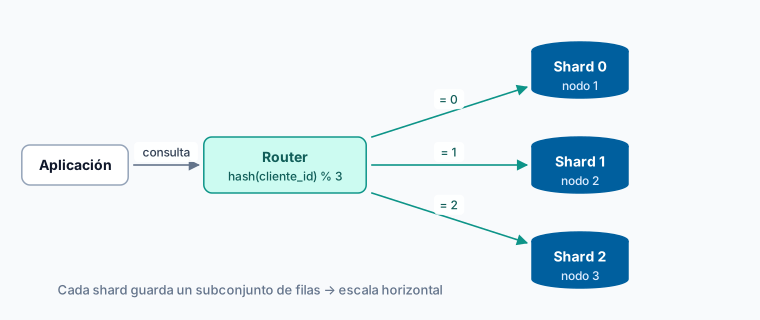
Sharding
¿Qué es?
El sharding es la técnica de repartir las filas de una base de datos entre varios servidores independientes, llamados shards, de forma que cada uno guarda solo una parte del conjunto total. Todos los shards tienen la misma estructura de tablas; lo que cambia es qué registros contiene cada uno.
Es una forma de escalado horizontal: en lugar de comprar una máquina más grande para aguantar más carga, se añaden máquinas y se reparte el trabajo entre ellas.
Cómo se reparten los datos
La decisión clave es la clave de sharding (shard key): el campo que determina en qué servidor acaba cada fila. Las estrategias habituales son:
- Por rango: cada shard cubre un intervalo de valores —clientes de la A a la M en uno, de la N a la Z en otro—. Sencillo de entender, pero propenso a repartos desiguales.
- Por hash: se aplica una función hash a la clave y el resultado decide el destino. Reparte de forma mucho más uniforme, a costa de perder la localidad: consultar un rango obliga a preguntar a todos los shards.
- Por directorio: una tabla de búsqueda mantiene explícitamente qué clave vive en qué shard. Muy flexible, pero convierte ese directorio en una pieza crítica.
Elegir mal la clave produce un shard caliente: un servidor que concentra la mayor parte de las peticiones mientras los demás están ociosos, con lo que se pierde todo el beneficio del reparto.
Para qué sirve
- Superar el límite de una sola máquina: cuando el volumen de datos o de escrituras excede lo que un servidor puede sostener.
- Repartir la carga de escritura: a diferencia de las réplicas de lectura, el sharding sí distribuye las escrituras.
- Acotar el impacto de un fallo: si cae un shard, solo queda indisponible la porción de datos que alojaba, no el sistema entero.
Qué se complica
El sharding no es gratis, y ese es su principal criterio de decisión:
- Consultas entre shards: cualquier operación que cruce datos de varios servidores —una unión, una agregación global— hay que resolverla consultando a todos y combinando resultados.
- Transacciones distribuidas: garantizar atomicidad sobre varios shards es caro y complejo. Muchos sistemas simplemente no lo ofrecen.
- Rebalanceo: añadir o quitar shards obliga a mover datos entre servidores, una operación delicada sobre un sistema en producción.
Por eso la recomendación práctica es agotar antes las alternativas —índices, réplicas de lectura, particionado dentro de un mismo servidor, archivado de datos históricos— y recurrir al sharding cuando el crecimiento realmente lo exige.
Sharding y sistemas distribuidos
Al repartir los datos entre máquinas, el sistema pasa a ser distribuido y hereda sus compromisos: ante un fallo de red hay que elegir entre seguir respondiendo o mantener la consistencia estricta. Es exactamente la tensión que describe el teorema CAP. Muchas bases de datos NoSQL incorporan el sharding de serie y gestionan ese reparto de forma automática.
Más información
- Teorema CAP — el compromiso que impone repartir datos entre máquinas
- NoSQL — la familia que suele traer sharding integrado
- Base de datos relacional — dónde el sharding se añade con más esfuerzo
- Base de datos documental — modelo habitualmente distribuido por shards
- OLTP — la carga transaccional que motiva la mayoría de los shardings
Para comparar motores y sus capacidades de escalado, el directorio de plataformas de datos de Dataprix recoge fichas y análisis editorial de las principales opciones.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.