Slice and dice: qué significa y cómo se aplica en un análisis OLAP
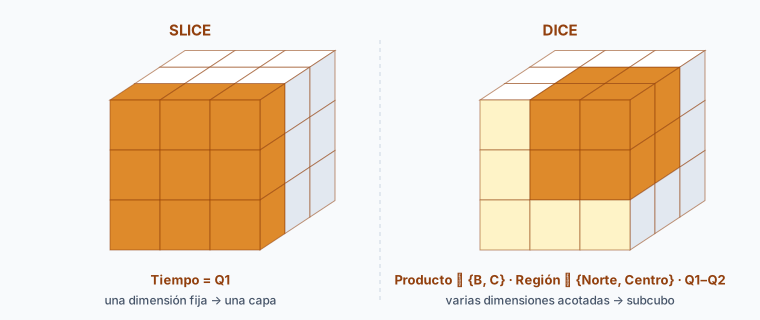
Slice and dice es la operación de recortar un conjunto de datos por sus dimensiones para mirarlo desde ángulos distintos, sin cambiar el nivel de detalle. Es la manera estándar de nombrar lo que casi todo el mundo hace de forma intuitiva al filtrar un informe.
Las dos mitades de la expresión son operaciones distintas, aunque en la práctica se usen juntas.
Slice («rebanar») fija un valor de una sola dimensión y se queda con esa lámina del conjunto. De todas las ventas, solo las de España. De todo el año, solo octubre. El resultado tiene una dimensión menos: al fijar el país, el país deja de ser una variable del análisis y pasa a ser parte del contexto.
Dice («trocear») restringe varias dimensiones a la vez, cada una a un subconjunto de valores. Ventas de España y Portugal, del primer trimestre, en las categorías A y C. El resultado sigue teniendo todas las dimensiones; lo que ha cambiado es que cada una está acotada. Es un subcubo, no una lámina.
Qué la diferencia del drill down
Es la distinción que más se confunde, y se resuelve con una sola pregunta: ¿ha cambiado el nivel de agregación?
El drill down baja por una jerarquía: de año a trimestre, de región a provincia. El dato se vuelve más fino. Slice and dice no baja ningún escalón: se queda en el mismo nivel y descarta lo que queda fuera del filtro. Se ve lo mismo, pero de menos cosas.
Hay una tercera operación que completa el vocabulario: pivot (o rotate), que consiste en intercambiar qué dimensión va en filas y cuál en columnas. Tampoco cambia el nivel ni el conjunto de datos, solo la disposición. Las tres juntas —recortar, profundizar y rotar— son básicamente todo lo que se hace en un análisis OLAP interactivo.
Por qué funciona bien en unos modelos y mal en otros
Que el usuario pueda cortar por donde quiera parece una cuestión de la herramienta, pero se decide antes, en el modelo.
Hacen falta dimensiones, no columnas sueltas. Solo se puede cortar por aquello que existe como atributo modelado. Si el canal de venta viaja embebido dentro de un código de producto, no hay forma de rebanar por canal por muchas opciones que ofrezca el informe. Esos atributos viven en las tablas de dimensiones.
Las medidas tienen que sobrevivir al filtro. Los importes y las unidades se recalculan sin problema sobre cualquier subconjunto. Los ratios, los porcentajes y las medias, no: hay que recomputarlos desde su numerador y su denominador dentro del corte. Un margen medio filtrado por región no es el margen medio general, y tampoco es la media de los márgenes regionales.
El grano marca el límite. No se puede cortar por debajo del nivel al que se guardó el dato. Si el almacén conserva ventas agregadas por mes y tienda, el corte por hora del día no existe, y el problema es de granularidad, no de la interfaz.
Dónde aporta y dónde se convierte en ruido
La utilidad real de slice and dice es acotar hasta que una diferencia se explique. La caída del trimestre no dice nada; la caída del trimestre en un canal concreto y una familia de producto concreta ya apunta a una causa.
El riesgo es el contrario y es frecuente: cortar tanto que el subconjunto deja de ser significativo. Con filtros suficientes casi siempre aparece un segmento donde algo sube o baja de forma espectacular, sobre todo si detrás hay pocos registros. Antes de sacar conclusiones de un corte muy fino conviene mirar cuántas observaciones lo sostienen.
Estas operaciones son el vocabulario clásico del análisis multidimensional y funcionan igual sobre un cubo materializado que sobre un modelo consultado directamente contra el almacén, siempre que el modelado dimensional esté bien planteado.
En el directorio de herramientas de Business Intelligence de Dataprix hay fichas y análisis de las plataformas que implementan esta navegación, y el diseño del modelo que la hace posible está tratado en la guía de arquitectura de datos.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.