Granularidad: qué es el grano de los datos y cómo elegirlo
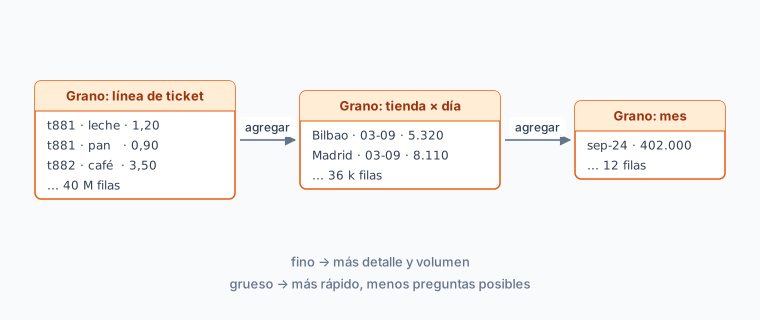
La granularidad —o el grano— es el nivel de detalle al que se guardan los datos: qué representa exactamente una fila de una tabla. Es una de las primeras decisiones de cualquier modelo analítico y una de las más caras de revertir.
Un mismo proceso de ventas admite granos muy distintos: una fila por línea de ticket, una por ticket, una por cliente y día, o una por tienda y mes. Los cuatro son válidos. Cada uno permite unas preguntas e imposibilita otras.
La regla asimétrica
Todo el criterio se resume en una asimetría: se puede agregar hacia arriba, pero no desagregar hacia abajo.
Desde el grano de línea de ticket se obtiene el total por ticket, por cliente, por tienda y por mes: basta con sumar. Desde el grano mensual por tienda no hay forma de saber qué productos se vendieron juntos, a qué hora hubo más afluencia, ni qué clientes repitieron. Esa información no está agregada: está perdida.
De ahí la recomendación práctica: guardar el grano más fino que el volumen y el presupuesto permitan sostener, y construir las agregaciones por encima. Rehacer el grano meses después implica rediseñar el modelo y recargar todo el histórico, si es que el origen todavía lo conserva.
Lo que cuesta el grano fino
La contrapartida es real y conviene decirla. Bajar el grano multiplica las filas, y con ellas el almacenamiento, el tiempo de carga y el coste de cada consulta que recorre la tabla.
El patrón habitual no es elegir entre uno u otro, sino combinarlos por capas: se conserva el detalle fino en la capa base, y sobre él se materializan agregados a los granos que consultan los informes del día a día. Los cuadros de mando leen el agregado, que es rápido y barato; el análisis puntual baja al detalle cuando hace falta. Esto es exactamente lo que hace un cubo OLAP al precalcular combinaciones de agregación.
El particionado es la otra palanca: mantener el grano fino deja de doler cuando las consultas solo leen las particiones del periodo consultado.
El grano tiene que ser uniforme
Un error silencioso y frecuente: mezclar en la misma tabla filas de detalle con filas ya agregadas. El resultado son dobles conteos. Al sumar, cada operación cuenta dos veces —una en su fila de detalle y otra dentro del agregado— y el total sale inflado sin que nada falle de forma visible.
Los totales inflados no producen errores, producen cifras plausibles. Suelen descubrirse semanas después, cuando un informe no cuadra con la contabilidad, y para entonces ya han circulado en varias presentaciones. La regla es explícita: todas las filas de una tabla de hechos, el mismo grano, y si se necesita otro nivel, va en otra tabla.
Declararlo antes de diseñar
En modelado dimensional el grano se declara en una frase, en lenguaje natural, antes de escribir una sola columna: «una fila por línea de pedido», «una fila por saldo de cuenta al cierre de cada mes».
Si esa frase no se puede escribir sin ambigüedad, el modelo todavía no está definido. Y una vez escrita, funciona como criterio de admisión: cualquier columna que no encaje en ese grano no pertenece a esa tabla. Es un filtro sencillo que evita buena parte de los modelos que crecen sin control.
En el directorio de plataformas de datos de Dataprix hay fichas y análisis de los motores donde se implementan estos modelos, y el criterio de diseño global está desarrollado en la guía de arquitectura de datos.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.