Data Vault: qué es y cuándo conviene este modelo de datos
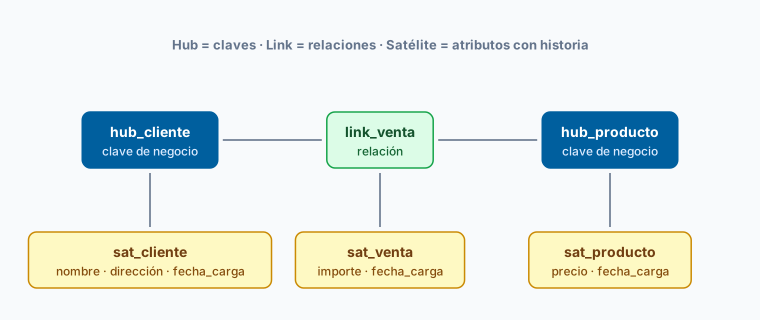
Data Vault es una técnica de modelado para almacenes de datos que separa las claves de negocio, las relaciones entre ellas y sus atributos descriptivos en tres tipos de tabla distintos. Su prioridad no es la comodidad de consulta, sino la trazabilidad: poder reconstruir en cualquier momento qué dato llegó, de qué origen y cuándo.
Los tres componentes
- Hub: guarda la clave de negocio y poco más. Un hub de cliente contiene el identificador de cliente, la fecha de carga y el origen del que vino. Nada que cambie con el tiempo.
- Link: representa una relación entre hubs. La asociación entre un cliente y un pedido vive en un link, no dentro de ninguna de las dos entidades.
- Satélite: contiene los atributos descriptivos y su historia. El nombre del cliente, su dirección o su segmento van en satélites, con marca temporal, de modo que cada cambio se añade en lugar de sobrescribir.
Esa separación es la clave del modelo: lo que identifica va por un lado, lo que relaciona por otro y lo que cambia por un tercero. Cuando un sistema origen añade un campo nuevo, se crea un satélite adicional sin tocar lo existente.
Para qué sirve
Data Vault resuelve bien tres situaciones concretas:
- Muchos sistemas origen que no se ponen de acuerdo. Cada uno carga en sus propios satélites y la reconciliación se hace después, en las capas de consumo.
- Requisitos de auditoría. Como nada se sobrescribe, se puede responder a la pregunta “qué sabíamos de este cliente en marzo del año pasado” sin recurrir a copias de seguridad.
- Modelos que cambian a menudo. Añadir un origen no obliga a rehacer el esquema; se enchufa con hubs y links nuevos.
Cuándo no compensa
Data Vault añade tablas y complejidad de carga. Es un modelo pensado para la capa intermedia del almacén, no para que los analistas consulten directamente contra él: encima suele construirse una capa de marts en modelado dimensional con esquemas en estrella, que es lo que consumen las herramientas de BI.
En un proyecto con pocos orígenes, sin exigencias de auditoría y con un equipo pequeño, la complejidad no se paga. La regla práctica: si nadie va a preguntar nunca por el histórico ni por la procedencia de un dato, un modelo dimensional directo es más barato de construir y de mantener.
Su relación con el historial de atributos lo conecta con las dimensiones de cambio lento, que resuelven un problema parecido dentro del modelo dimensional clásico.
En el directorio de plataformas de datos de Dataprix hay fichas y análisis de los motores donde se implementan estos modelos, con el veredicto editorial de cada uno.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.