Modelo en estrella (star schema): qué es y por qué se usa en BI
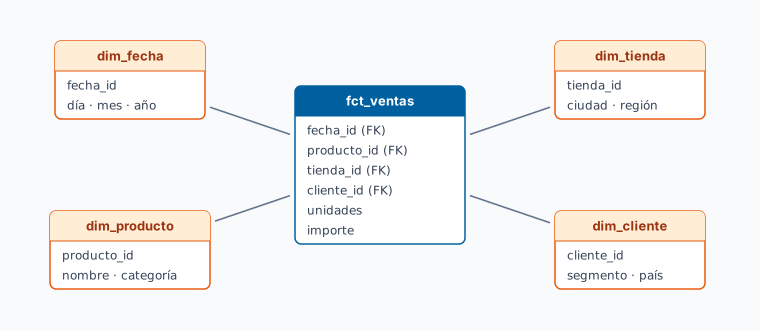
Modelo en estrella (star schema)
¿Qué es?
El modelo en estrella (star schema) es el patrón de modelado dimensional más usado en data warehouses, propuesto por Ralph Kimball en los años 90. Organiza los datos analíticos en torno a:
- Una tabla de hechos (fact table) en el centro, que almacena las métricas del negocio.
- Varias tablas de dimensiones (dimension tables) alrededor, que describen los contextos de esos hechos.
El nombre viene del diagrama: la tabla de hechos en el centro y las dimensiones radiando como puntas de una estrella.
Estructura básica
                    dim_tiempo
                        |
                        |
    dim_producto --- fact_ventas --- dim_cliente
                        |
                        |
                    dim_geografia
Tabla de hechos
Contiene métricas cuantificables (importes, cantidades, duraciones) y claves foráneas a las dimensiones. Es típicamente la tabla más grande del DW (millones o miles de millones de filas).
Ejemplo fact_ventas:
| pedido_id | tiempo_id | cliente_id | producto_id | geografia_id | cantidad | importe | margen |
|---|
Tablas de dimensiones
Contienen los atributos descriptivos. Son tablas más pequeñas (cientos a millones de filas), denormalizadas a propósito para evitar joins.
Ejemplo dim_cliente:
| cliente_id | nombre | segmento | sector | pais | tamaño | comercial_actual |
|---|
Por qué se denormaliza
Un modelo OLTP estaría en 3FN (tercera forma normal): cliente → cuenta → pais → continente, en tablas separadas. En el DW se denormaliza intencionalmente:
- Menos joins = consultas más rápidas.
- Más comprensible para analistas y herramientas BI.
- El espacio es barato, el tiempo de analista no.
Ejemplo
Pregunta de negocio: “Margen total Q1 2026 por sector y país, productos categoría A”.
En modelo estrella, una sola consulta SQL:
SELECT c.sector, g.pais, SUM(f.margen) AS margen_total
FROM fact_ventas f
JOIN dim_cliente c ON f.cliente_id = c.cliente_id
JOIN dim_producto p ON f.producto_id = p.producto_id
JOIN dim_geografia g ON f.geografia_id = g.geografia_id
JOIN dim_tiempo t ON f.tiempo_id = t.tiempo_id
WHERE t.trimestre = 'Q1-2026' AND p.categoria = 'A'
GROUP BY c.sector, g.pais
Cinco joins, todos por clave única. Un motor analítico (Snowflake, BigQuery, Redshift) lo resuelve en segundos sobre miles de millones de filas.
Estrella vs copo de nieve
El copo de nieve (snowflake schema) normaliza las dimensiones:
fact_ventas → dim_producto → dim_categoria → dim_familia
| Estrella | Copo de nieve | |
|---|---|---|
| Joins | Pocos | Muchos |
| Espacio | Más | Menos |
| Performance consultas | Mejor | Peor |
| Mantenimiento | Más simple | Más complejo |
| Cuándo usarlo | Por defecto | Solo si la dimensión es enorme y comparte mucha jerarquía |
Regla práctica: empieza con estrella. Pasa a copo de nieve solo si tienes una razón muy clara (típicamente, dimensiones con cientos de millones de filas y atributos compartidos).
Buenas prácticas
- Surrogate keys: usa IDs propios del DW (
cliente_idautoincremental), no las claves originales del sistema operativo. Te permite gestionar SCD Tipo 2 sin colisiones. - Conformed dimensions: si tienes varios facts (
fact_ventas,fact_compras), comparte las dimensiones (dim_cliente,dim_producto). Permite cruzar datos entre áreas. - Calendario poblado por adelantado:
dim_tiempocon todos los días del horizonte, con campos derivados (día de la semana, trimestre, festivo, semana ISO). - Aplica SCD apropiadamente según el atributo: tipo 1 para correcciones, tipo 2 para cambios con valor histórico.
Más información
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.