Data FinOps: qué es y cómo controla el coste cloud de los datos
Data FinOps
¿Qué es?
Data FinOps es la aplicación de las prácticas FinOps (Financial Operations) al gasto cloud específico de las plataformas de datos: data warehouses, lakehouses, motores de consulta, herramientas de orquestación y servicios de IA gestionados. Combina disciplina de visibilidad financiera, atribución por equipos y proyectos, y optimización técnica continua para mantener bajo control un gasto que en muchas organizaciones modernas crece más rápido que cualquier otra partida de TI.
Por qué surgió como disciplina específica
FinOps como práctica general (orientada a EC2, ECS, S3 y resto de infraestructura cloud) existe desde hace años. El motivo de especializar en datos es operativo: las plataformas analíticas tienen patrones de gasto y palancas de optimización distintos al resto de la nube:
- Coste por consulta: en Snowflake, BigQuery o Databricks, una sola query mal escrita puede costar cientos de euros. En infraestructura clásica, la unidad de coste es la instancia, no la operación.
- Auto-escalado opaco: warehouses serverless escalan automáticamente. Sin visibilidad granular es difícil saber qué carga concreta disparó el bill.
- Pricing complejo: Snowflake cobra por crédito + storage + transferencia; Databricks por DBU según tipo de cluster; BigQuery por bytes procesados o slot reservation. Cada plataforma exige conocimiento específico para optimizar.
- Multitenant interno: el mismo warehouse sirve a 20 equipos, cada uno con sus propias queries. Atribuir coste a equipos requiere instrumentación específica.
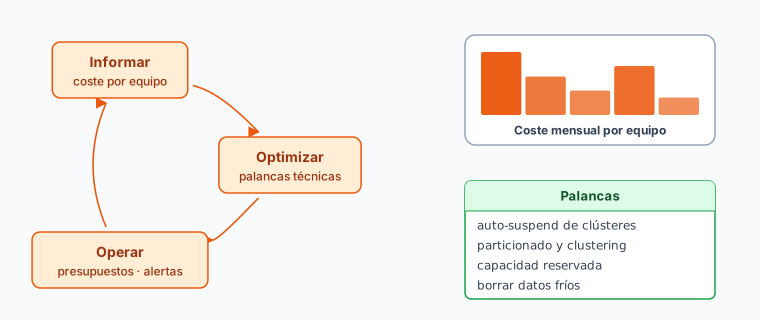
Las tres fases del ciclo Data FinOps
Heredadas de FinOps general pero aplicadas al contexto datos:
1. Informar (visibilidad)
- Centralizar facturas de Snowflake, Databricks, BigQuery, Airflow gestionado, etc.
- Atribuir consumo a equipos, proyectos, productos de datos. Mediante tags en queries, separación por warehouse, schemas dedicados o herramientas de atribución.
- Construir dashboards que muestren coste por equipo, por modelo dbt, por tipo de carga (analítica, ad hoc, recurrente, ML).
2. Optimizar (reducir desperdicio)
- Right-sizing: ajustar tamaño de warehouses a la carga real, no al pico puntual.
- Auto-suspend agresivo: que el warehouse se duerma cuando no hay tráfico.
- Cache aggressive: aprovechar caché de queries repetidas.
- Refactor de queries caras: las top 20 queries por coste suelen tener un patrón mejorable identificable.
- Materialización selectiva: para queries recurrentes, materializar resultados intermedios.
- Storage tiering: archivar datos fríos en clases de almacenamiento baratas.
3. Operar (gobernanza continua)
- Definir presupuestos por equipo y alertar cuando se superan.
- Establecer SLAs de coste por query y dashboard.
- Revisar mensualmente y ajustar.
- Integrar el coste en el ciclo de CI/CD: los cambios que disparan el bill se detectan antes del merge.
Métricas clave
Las métricas que diferencian un programa de Data FinOps maduro:
| Métrica | Qué mide |
|---|---|
| Coste por GB analizado | Eficiencia del motor sobre datos crudos |
| Coste por query | Identifica queries outlier que cuestan desproporcionadamente |
| Coste por dashboard / día | Visibilidad downstream de qué dashboards son caros |
| % uso del warehouse | Detecta sobredimensionamiento |
| Coste por equipo / mes | Atribución para presupuestos |
| Coste por modelo dbt | Detecta modelos que ejecutan sin uso real |
Tecnologías y proveedores
El segmento ha madurado mucho desde 2024:
- Plataformas dedicadas Data FinOps: Unravel (con su nuevo Arvix AI de optimización autónoma), Sync Computing, Bluesky Data, Capital One Slingshot.
- Funciones nativas: Snowflake Resource Monitors, Databricks Budget Policy, BigQuery Slot Estimator.
- Open source: dbt-coverage, dbt-checkpoint, OpenLineage para entender qué procesos están corriendo.
- Observabilidad clásica con cobertura de datos: Datadog tras adquirir Metaplane, New Relic.
Ejemplo
Una scaleup B2B SaaS migra a Snowflake. En el primer trimestre el bill mensual crece de 8.000 € a 23.000 € sin que se haya añadido carga proporcional. Aplica Data FinOps:
- Visibilidad: identifica que 11 modelos dbt consumen el 60 % del gasto. De esos 11, solo 4 alimentan dashboards activos.
- Optimización: retira de la cadencia diaria los 7 modelos sin consumidores, refactoriza los 4 críticos eliminando joins redundantes, ajusta el warehouse principal de Large a Medium con auto-suspend a 60 s.
- Operar: crea presupuestos por equipo, alerta al exceder umbrales, revisa el top 10 de queries por coste cada lunes.
Resultado: el bill estabilizado en 12.000 € con la misma capacidad analítica de negocio. Reducción del 48 % sin pérdida funcional.
Limitaciones y consideraciones
- No es solo coste: optimizar agresivamente puede impactar latencia y experiencia. El balance correcto exige decisiones de negocio, no técnicas puras.
- Necesita tooling y disciplina: sin instrumentación seria, el “FinOps” se reduce a recortes reactivos que generan tensión organizacional.
- El gasto IA generativa cambia las reglas: con Snowflake Cortex, Databricks Mosaic AI y similares, el coste por token añade una dimensión nueva al cálculo. Programas Data FinOps actualizados ya incluyen “Token FinOps”.
Más información
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.